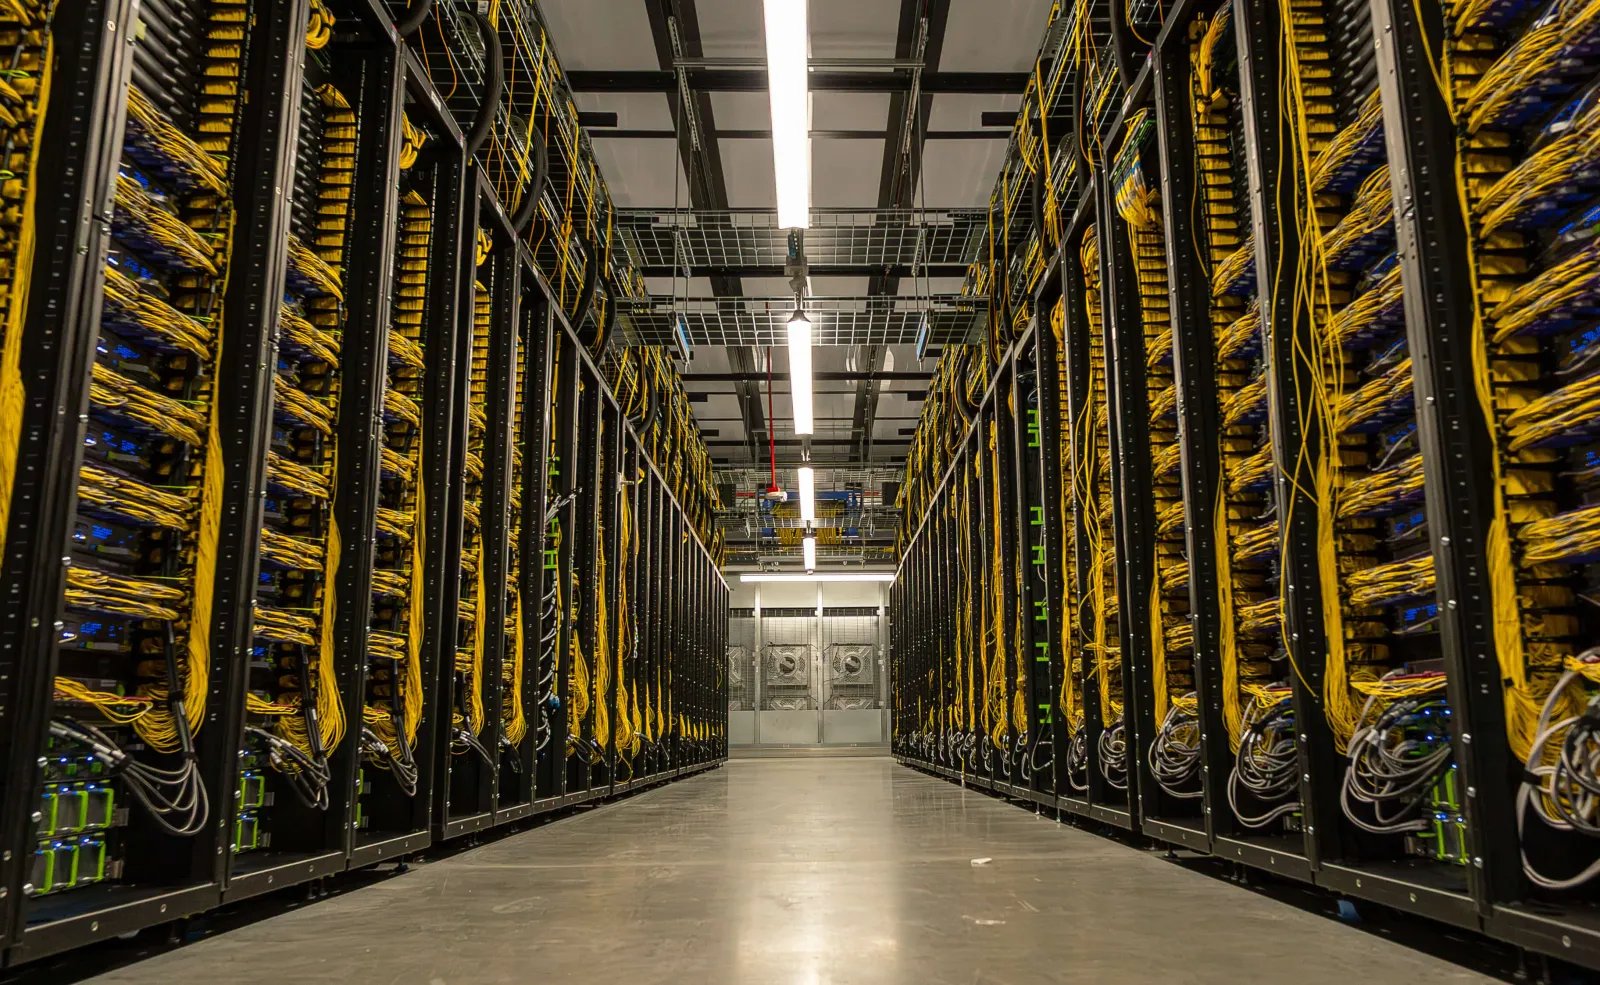
Meta завърши първата фаза на суперкластера Prometheus в Ню Олбани, Охайо, и за пръв път публикува подробни числа за това как го поддържа жив. Най-любопитното: над 11% от инсталираните ускорители Nvidia по всяко време не вършат никаква работа. Част от тях са дефектни, но повечето просто чакат — за да заместят следващия GPU, който ще се счупи. Данните са от техническия блог на компанията от 19 октомври, Inside Prometheus, а The Register първи обърна внимание на мащаба на този резерв.
64 работят, 8 чакат
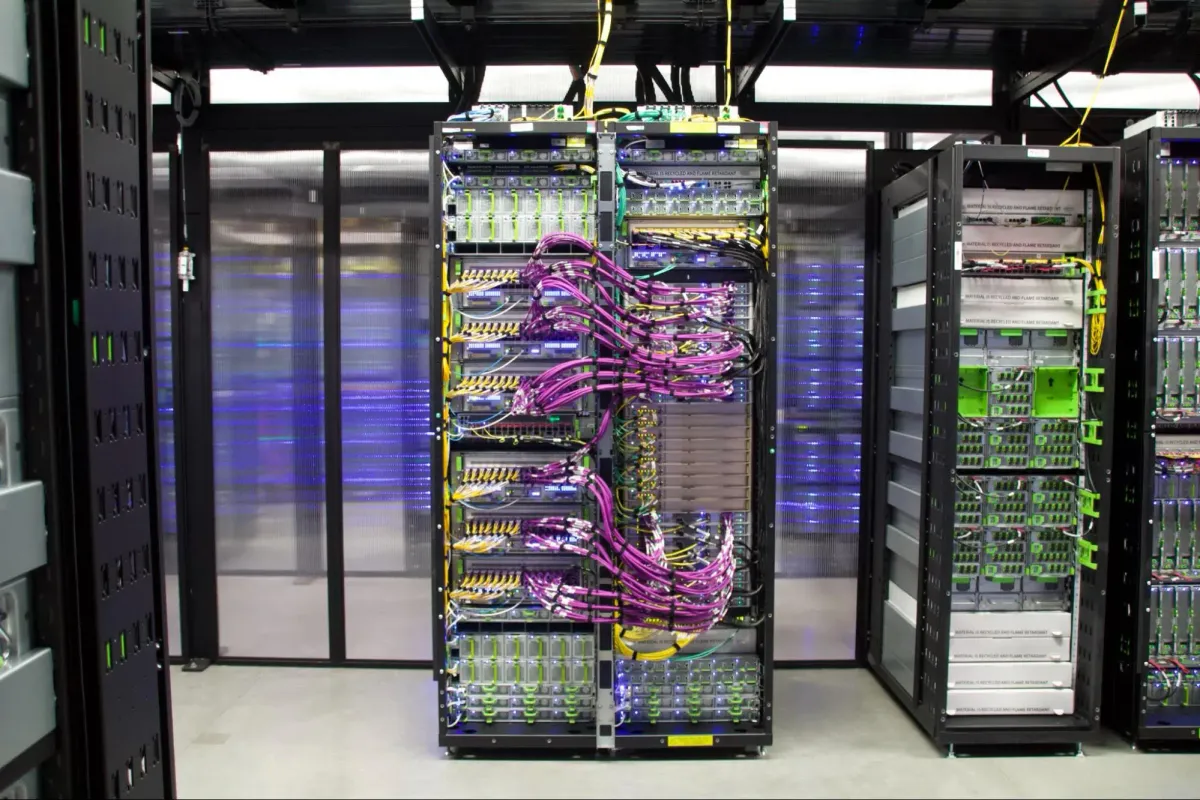
Prometheus е построен върху шкафове Nvidia Grace Blackwell — NVL72, с 72 GPU в един NVLink домейн. Meta обаче не използва всичките 72. Всеки шкаф върти работен отрязък от 64 ускорителя, а останалите 8 стоят като горещ резерв вътре в самия шкаф.
Логиката е проста. Когато един GPU падне, резервен от същия шкаф влиза на негово място веднага и задачата се възстановява от последния checkpoint, вместо да чака техник, подмяна на платка и повторно валидиране. Шкафът остава в обучението.
За по-редките случаи, в които се поврежда цял шкаф, Meta пази около 2% допълнителни шкафове в готовност. Сборът от геометрията 64-от-72 и резервните шкафове дава около 13% провизиониран излишък над активния отпечатък — при кластер от стотици хиляди ускорители това са десетки хиляди карти.
Пример от самата компания: тренировъчна задача с 32 768 активни GPU на практика заема 523 шкафа, или 37 656 физически ускорителя.
От 1000 прекъсвания на ден до 11
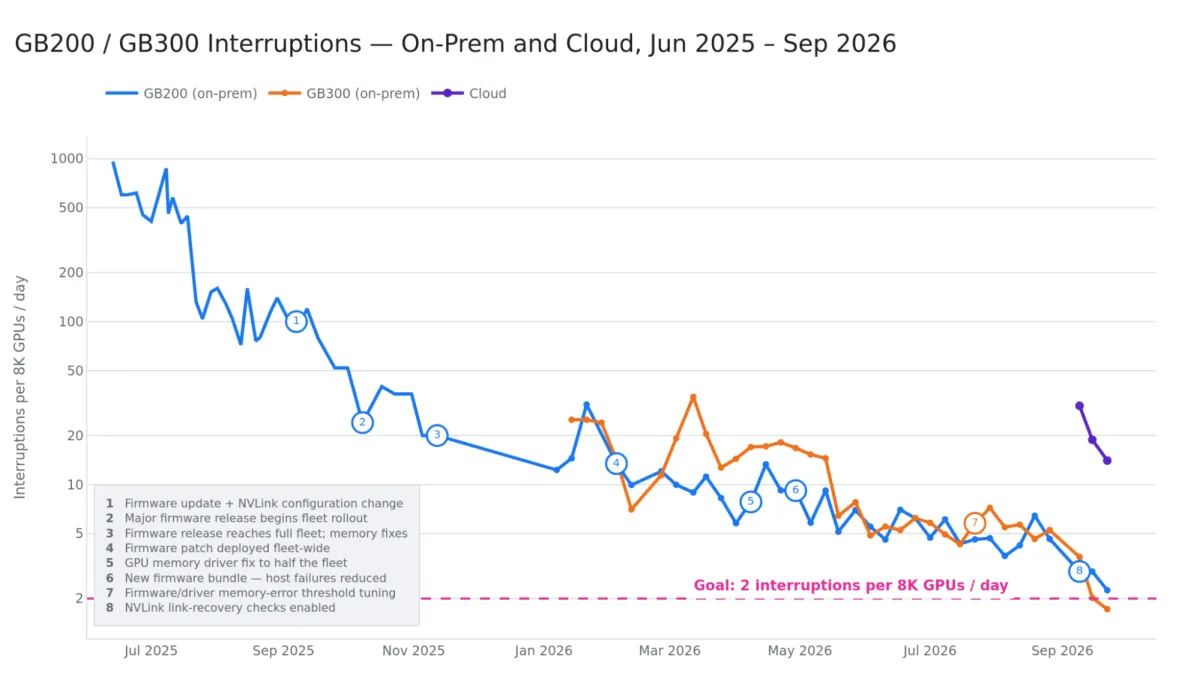
Числата за надеждността обясняват защо този резерв не е разхищение. В средата на 2025 г., докато кластерът се изгражда, Meta отчита близо 1000 прекъсвания на обучението дневно на всеки 8000 GPU. Днес същият показател е около 11 на ден — спад от 99%.
 Снимка: Engineering at Meta
Средното време между прекъсванията (MTBI) е тръгнало от около 47 000 GPU-часа и след серия поправки във firmware минава 54 000. Целта, която Meta нарича своя „северна звезда“, е две прекъсвания на 8000 GPU дневно, или приблизително 100 000 GPU-часа MTBI.
Другият показател е „goodput“ — какъв дял от наличното време наистина отива в полезно обучение. При предварителното обучение Meta съобщава за над 85%, а при обучението с подсилване на моделите от семейството Muse — над 90%.
Защо толкова се чупи
Мащабът сам по себе си е причината. Един NVL72 домейн съдържа 5184 диференциални сигнални линии по 200 Gbps, а в целия кластер има над 600 000 NVLink пътеки, които трябва да се следят с телеметрия и да се подлагат на диагностични тестове преди всяко пускане в работа. Към това се добавят десетки хиляди комутатори, милиони оптични модули и милиони мили оптично влакно.
Плътността също тежи. Двойката шкафове Catalina с GB200 консумира около 120 kW, по-новите Clemente с GB300 — около 135 kW на шкаф, а предстоящите San Miguel с Vera Rubin минават 170 kW на шкаф и обещават 10–20% по-добра производителност на ват спрямо GB300. Когато хиляди GPU едновременно влизат и излизат от пълно натоварване, токовите скокове стават проблем за самото електрозахранване и Meta пише, че се налага отделно смекчаване на тези преходни процеси.
 Снимка: Engineering at Meta
Асинхронни checkpoint-и и изолирани реплики
Освен резервния хардуер Meta разчита на два софтуерни механизма. Първият е асинхронно разпределено записване на състоянието — модел, градиенти и данни на оптимизатора отиват в многослойно хранилище, без обучението да спира.
Вторият е изолирането на повреда до едно копие от данновия паралелизъм. „Когато дефектът може да бъде изолиран до една реплика на модела, намаляваме въздействието на хардуерната авария, като извадим само тази реплика офлайн, докато останалата част от кластера повтаря стъпката и продължава полезното обучение“, пише компанията.
Поддръжката също е ускорена: ъпдейт на един pod отнема около 2 часа при P90 вместо предишните над 7, а разпространяването на нов firmware до над 100 000 GPU става за няколко часа.
Контекст
Prometheus е превърнат от обикновен център за данни в суперкластер за около две години и в крайния си вид трябва да стигне около милион ускорителя при гигават мощност. Следващият обект, Hyperion в окръг Ричланд, Луизиана, залага на напълно затворено течно охлаждане и мрежови архитектури от ново поколение.
Числата на Meta са полезни и извън контекста на компанията: те показват, че в днешните AI фабрики надеждността се купува с хардуер, който умишлено стои без работа. Същата логика виждаме и при други изчислителни архитектури — Quantinuum отчита 5 логически грешки на милион цикъла именно защото харчи физически кубити за корекция на грешки. А че Nvidia GPU не са безотказни черни кутии, напомнят и по-малките истории от екосистемата, като инструмента за смяна на vBIOS на GeForce без флашване.
Харесва ви? Отбележете ни и ще ни виждате по-нагоре в Google.
Предпочитан източник в Google