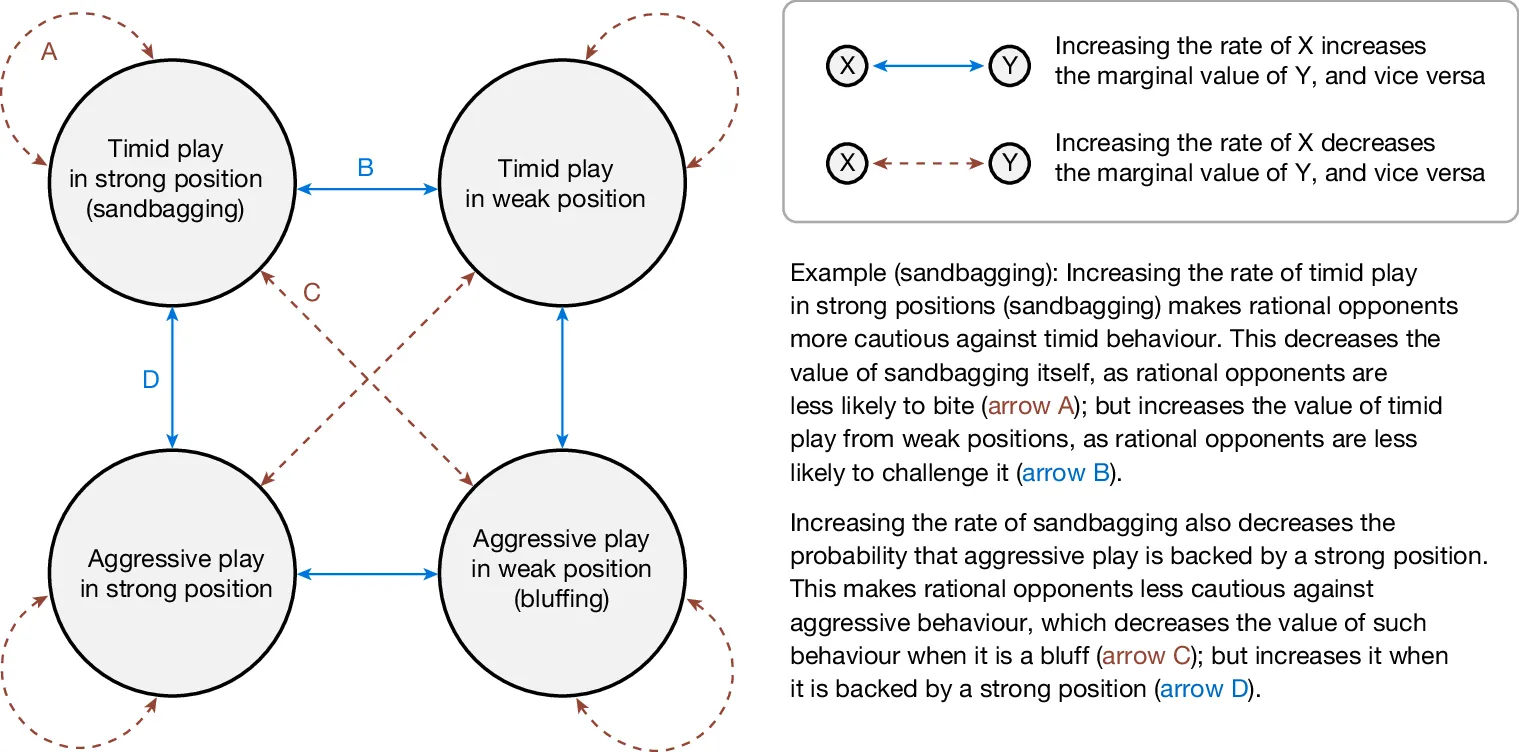
Stratego остана последната голяма настолна игра, в която хората държаха предимство срещу машините. Вече не. Система на име Ataraxos, разработена от екип на Carnegie Mellon, NYU, Stanford и MIT, спечели официален мач от 20 партии срещу нидерландеца Пим Нимайер — 15 победи, 1 загуба и 4 ремита. Изследването излезе на 30 септември в Nature под заглавието „Scalable decision-making for games of imperfect information“ (Nature, т. 658, с. 55–59).
Нимайер не е просто силен играч. Той има четири световни титли, 15 национални титли на Нидерландия, две титли от онлайн световни шампионати и над 600 седмици на първо място в световната класация. Джордж Франка, участник във всеки световен шампионат от 1997 г. насам, го определя като „най-добрия играч на Stratego на всички времена“.
Защо точно Stratego беше трудната игра
В шаха и в го виждате цялата дъска. В Stratego всеки от двамата играчи подрежда 40 фигури с лице надолу, преди да започне играта, и типът на фигурата се разкрива само когато тя влезе в бой. Възможните начални разположения са над 10³³.
Това променя природата на задачата. Както пишат авторите, „стойността на един ход зависи не само от това как играта продължава след него, но и от това какво се е случило преди и по време на самото решение“. С други думи, не можете да оцените позицията изолирано — трябва да моделирате и какво противникът предполага за вас.
Три части, нито един човешки мач за обучение
Ataraxos се състои от три компонента. Policy–value мрежа, обучена чрез self-play, която предлага ходове и прогнозира изхода от партията. Belief мрежа, която моделира скритата информация — тоест генерира хипотези какви са фигурите на противника. И процедура за търсене, която доуточнява избора в момента на хода.
Ключовата техническа находка е регуляризация, която кара системата да разнообразява стратегиите си, вместо да се вкопчи в един предсказуем шаблон още в началото на обучението. Човешки партии не са използвани — моделът се е учил само срещу себе си.
Играчите описват стила на Ataraxos като непредсказуем: прави рискови блъфове, от които хората се въздържат, и преминава към защитно забавяне, когато изостава.
Сметката: 16 GPU срещу 1024 TPU възела
Най-интересното число в тази история не е 15:1. DeepNash — предишният сериозен опит, дело на DeepMind — е тренирана върху 1024 TPU възела за два до три месеца, което авторите оценяват на 3 до 4,5 милиона долара (приблизително 2,6–4 млн. евро) по цени от 2025 г. На световния шампионат през 2023 г. DeepNash спечели 19 от 28 партии, но загуби от водещите играчи, включително от Нимайер.
Ataraxos е тренирана една седмица върху 16 ускорителя Nvidia H100, плюс още четири дни върху четири GPU за belief мрежата. Общата сметка: под 8000 долара (около 7000 евро) — приблизително 1/500 от разхода на DeepNash. Тази посока на развитие — повече резултат от по-малко изчисления и отворен код — се вижда и при други проекти, например при отворените библиотеки на DeepSeek за чиповете Ascend.
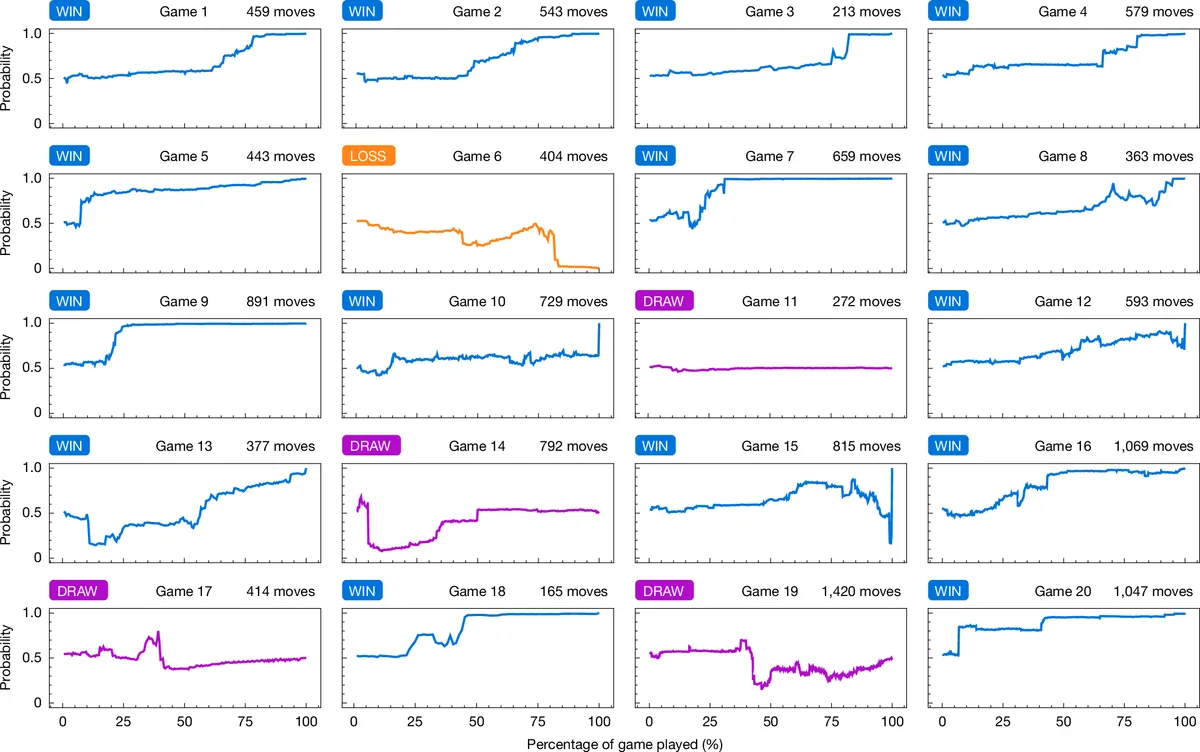 Снимка: Sokota и колектив, Nature
Как протече мачът
Партиите са изиграни в рамките на три седмици. Ataraxos е играла с фиксирана стратегия — тоест не се е доучвала между партиите — и Нимайер е бил предварително информиран за това ограничение, което теоретично му давало шанс да го използва. Ефективният процент победи на системата е 85% (ремитата се броят за половин победа).
Това не е първата публична изява. На показен мач по време на световния шампионат през 2025 г. Ataraxos печели 38 от 40 партии срещу турнирни играчи. Всички 20 партии срещу Нимайер са достъпни за преглед на страницата на проекта, а кодът е публикуван под MIT лиценз в GitHub.
Защо резултатът има значение извън дъската
Авторите — Samuel Sokota, Eugene Vinitsky, Hengyuan Hu, Zhiyuan Fan, J. Zico Kolter и Gabriele Farina — прилагат същата методика и към Barrage Stratego, Hanabi и dou dizhu, тоест към състезателна, кооперативна и отборна игра. Изводът им е предпазлив, но ясен: големите количества скрита информация вече не са пречка за reinforcement learning и търсене.
Тук е добре да се спрем, преди изводите да станат твърде големи. Stratego е игра с точни правила и ясен край; финансовите пазари, преговорите и военните сценарии, които авторите споменават като възможни приложения, не са. Същата логика обаче вече тръгва към области, в които решенията се вземат при непълна информация — включително новото командване на Пентагона за автономна война.
Заключение
За играчите на Stratego новината е носталгично горчива: падна последната голяма настолна игра, в която хората държаха превес. За останалите по-важното е другото число — 8000 долара. Резултат, който преди четири години изискваше хиляда TPU възела, днес се получава с шестнайсет GPU и седмица време. Това прави изследването повторимо от университетски екип, а не само от компания с облачна инфраструктура — и точно това, а не крайният резултат, вероятно ще се окаже по-трайната част от статията.
Източници: Nature, The Decoder, Ars Technica.
Харесва ви? Отбележете ни и ще ни виждате по-нагоре в Google.
Предпочитан източник в Google