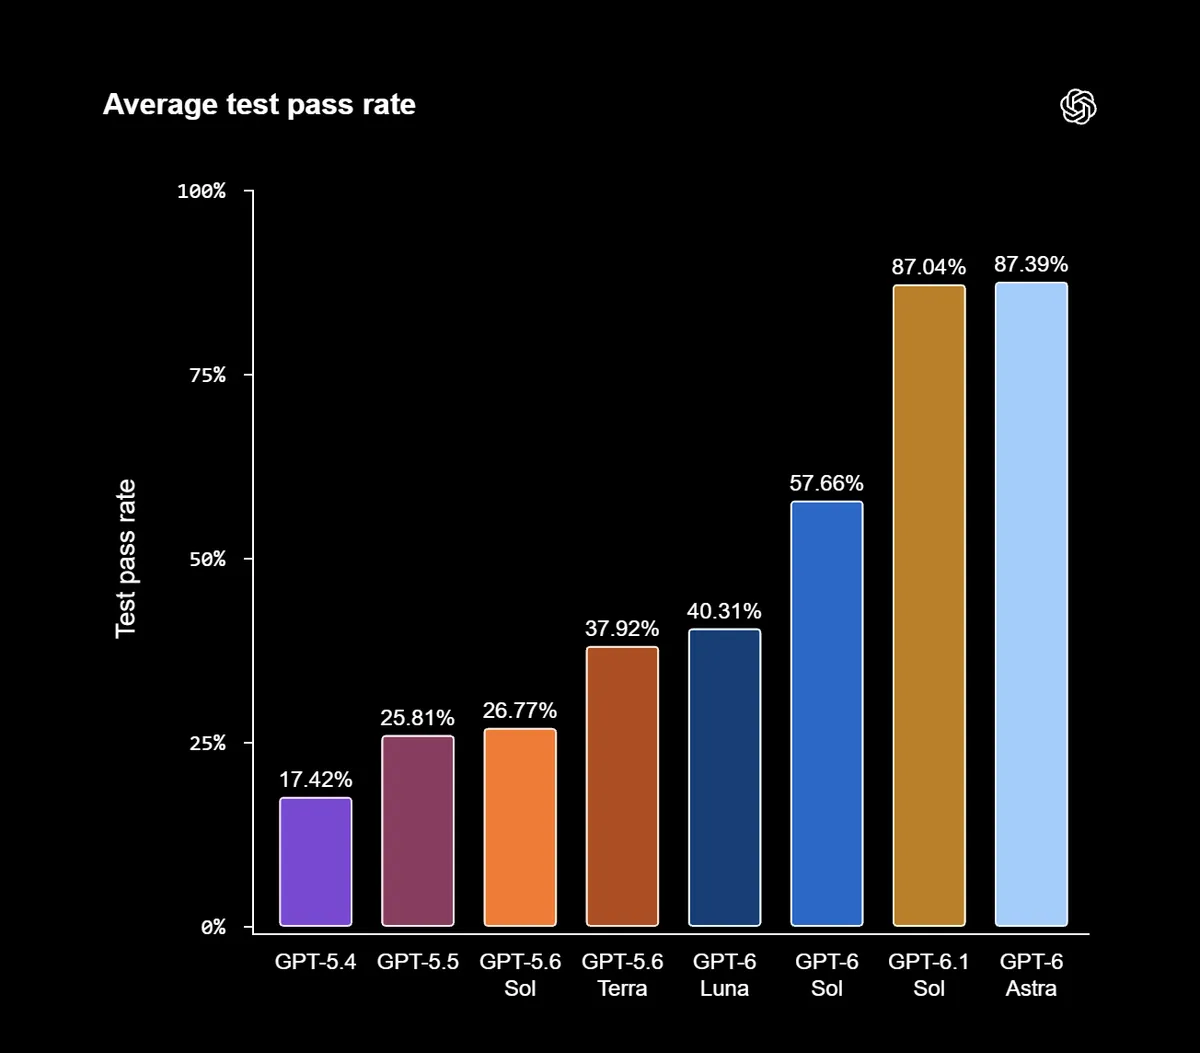
OpenAI публикува на 20 октомври резултати, според които най-новите ѝ модели се справят значително по-добре с така наречените low-resource езици за програмиране — COBOL, Fortran, Visual Basic и други, за които в интернет има несравнимо по-малко код и документация от Python или JavaScript. Заедно с обявлението компанията пусна два нови benchmark-а: MultiLangBench и отделна оценка за миграция на COBOL. Числата са впечатляващи, а най-голямото подобрение е при превода на стар код към модерни езици.
Какво измерва MultiLangBench
Задачата е брутална по дизайн: моделът трябва да напише от нулата съвместим със SQLite 3.40.1 database engine, като разполага само с документацията — и да го направи в 20 различни езика. Проверката е практична, не стилистична. Репозиторито на OpenAI в GitHub съдържа 24 000 теста, конвертирани от оригиналните 51 000 TCL теста на SQLite; всеки тест вдига база данни, пуска заявка и сравнява изхода с контролна заявка. Тестът минава само при точно съвпадение — грешен резултат, crash или изпълнение над 60 секунди се броят за провал. За по-бързи пускания се ползва подмножество от 272 теста.
Резултатите, които OpenAI отчита:
| Език | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| Средно за 20 езика | 26,8% | 87,4% |
| COBOL | 10,9% | 72,1% |
| Fortran | 21,4% | 83,5% |
| OCaml | 25,6% | 85,8% |
| Visual Basic | 27,5% | 89,4% |
19 от 20-те езика минават границата от 83%. COBOL остава най-трудният — 72,1% е голям скок, но все пак е най-ниската оценка в таблицата.
Интересен е и по-евтиният модел: GPT-6 Luna стига до 40,3% среден дял преминали тестове при около 0,77 долара на проба срещу 3,48 долара за предходното поколение — приблизително 78% по-ниска оценена цена за API.
Миграцията на COBOL е същинската новина
Вторият benchmark е по-близо до това, което банките реално плащат да се свърши: превод на COBOL програми към C++, Java, Kotlin, Python или Rust, с изискване изходът да съвпада байт за байт с оригинала.
Тук скокът е най-резкият. При ниско reasoning effort GPT-6.1 Sol постига 86,6% точност, докато GPT-5.6 Sol при същата настройка остава на 5,4% — тоест предишното поколение на практика не можеше да върши тази работа. При по-висок reasoning effort GPT-6.1 Sol стига до 97,9%. Изчислителната сметка също пада: ниската настройка излиза с около 39% по-малко разходи за API от предишния модел.
Числата идват от самата OpenAI и не са потвърдени от независима страна, което е обичайната уговорка при вътрешни benchmark-ове. Разликата е, че този път конфигурацията на MultiLangBench е отворена под лиценз Apache 2.0, така че всеки може да пусне оценката сам и да види резултатите за езиците, които ползва.
Защо това има значение
Причината OpenAI да се занимава с 67-годишен език е проста — COBOL все още държи критична инфраструктура. По оценки на IBM, които компанията цитира, COBOL обслужва над 40% от системите за онлайн банкиране, около 80% от картовите трансакции на място и 95% от трансакциите на банкомати. Fortran пък е основа на кода за прогноза на времето и за анализ на безопасността на ядрени реактори.
Проблемът не е само технически, а демографски: програмистите, които поддържат този код, се пенсионират, а документацията често е оскъдна или липсва. Досега вариантите бяха два — да наемете скъп специалист, или да не пипате нищо. Модел, който може да разчете стара процедура и да я пресъздаде в Java с идентичен изход, сменя сметката.
Какво остава неясно
Байт за байт съвпадение на изхода не е същото като еквивалентна програма. Реалните мейнфрейм системи висят на JCL скриптове, CICS трансакции, VSAM файлове и десетилетия натрупана бизнес логика, която никъде не е записана. Benchmark от самостоятелни COBOL програми не покрива тази част, а именно тя обикновено проваля проектите за модернизация.
Струва си да отбележим и че OpenAI напоследък редовно обявява резултати, които после се оказват по-сложни при по-близък прочит — както при доказателството около хипотезата на Риман. При агентните benchmark-ове пък видяхме, че дълги автономни задачи се решават, но с много опити — като четирите агента на Gemini в Minecraft.
Заключение
Ако числата се задържат и при независими проверки, това е едно от по-практичните приложения на новото поколение модели: не нова функционалност, а разчистване на техническия дълг, който никой не иска да пипа. Подробностите са в обявлението на OpenAI, а първите разчети — в материалите на BleepingComputer и The Decoder. Отвореният код на benchmark-а е най-добрата новина в целия пакет — проверката вече не зависи само от думата на OpenAI.
Харесва ви? Отбележете ни и ще ни виждате по-нагоре в Google.
Предпочитан източник в Google