Китайската DeepSeek пусна днес, 17 октомври 2026 г., обновена версия на своя лек модел — DeepSeek-V4.1-Flash-1017. Тя е достъпна веднага през сайта, приложението и API на компанията, а теглата са качени в Hugging Face и ModelScope под MIT лиценз. Основното твърдение: по кодиране и агентни задачи моделът изпреварва значително по-скъпи конкуренти, а цената на изпълнена задача пада няколко пъти.
Какво показват числата
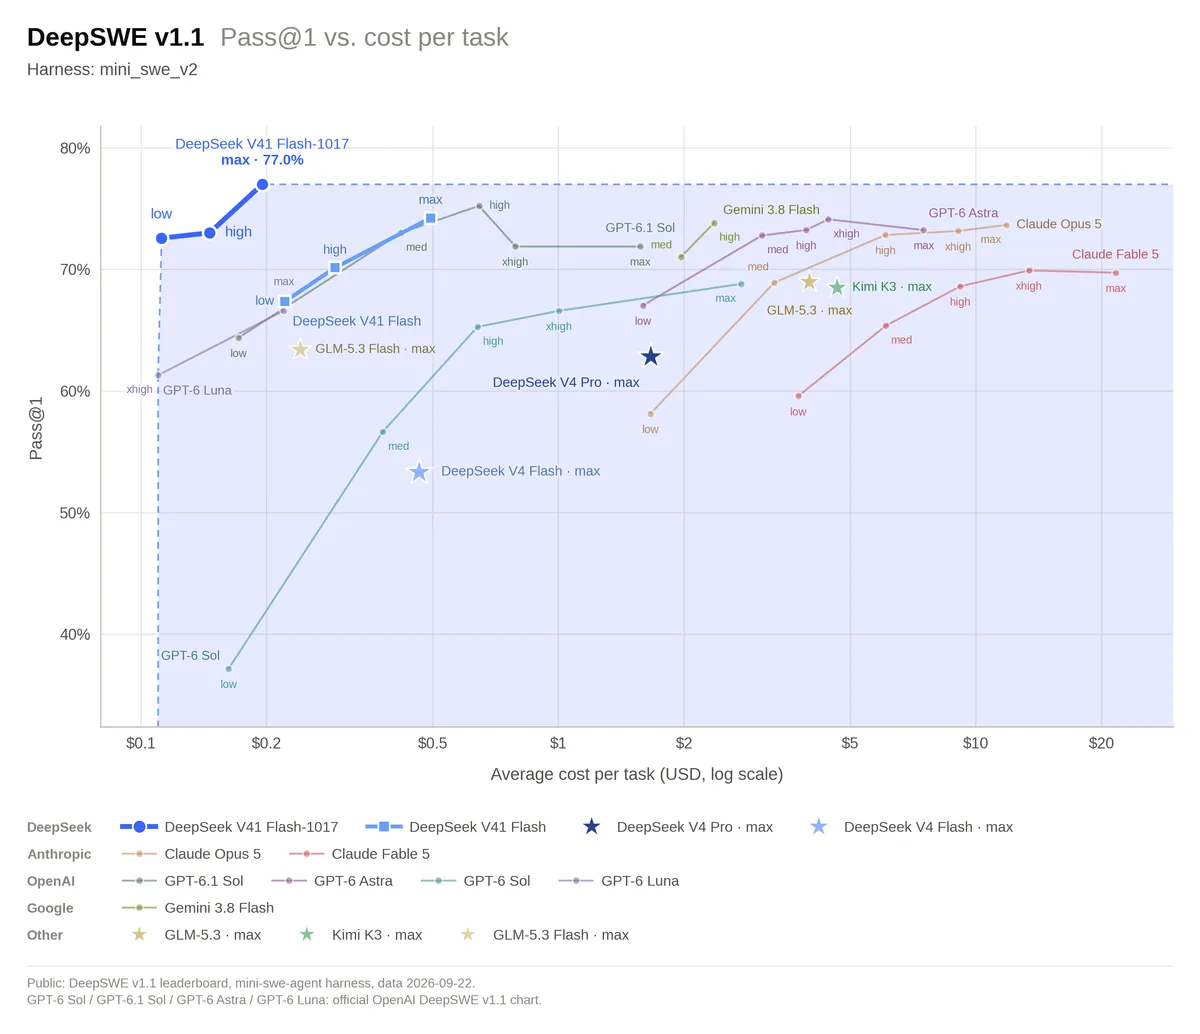
Според официалното съобщение на DeepSeek новият чекпойнт подобрява всички 11 публикувани бенчмарка спрямо предишния V4.1-Flash. Най-коментираният резултат е на DeepSWE v1.1 — тест за реални задачи по софтуерна поддръжка, пускан през harness-а mini-swe-v2.
 Снимка: DeepSeek
Там V4.1-Flash-1017 постига 77,0% pass@1 при около 0,20 щ.д. на задача (приблизително 0,18 €). При по-пестеливата настройка моделът пада до 72%, но цената също се свива — до около 0,10 щ.д. (около 0,09 €). За сравнение, предшественикът му стига до 74,2%, но му трябват около 0,43 щ.д. на задача.
Контекстът прави разликата видима. Както отбелязва The Decoder, сравними агентни задачи при GPT-6 Astra, Gemini 3.8 Flash и Claude Opus 5 излизат между 2 и над 10 щ.д. Тоест говорим за порядък, а на моменти и два, разлика в сметката — при съпоставима или по-добра точност по част от тестовете, включително срещу Claude Opus 5, GPT-5.6 Sol, Kimi K3 и GLM 5.3.
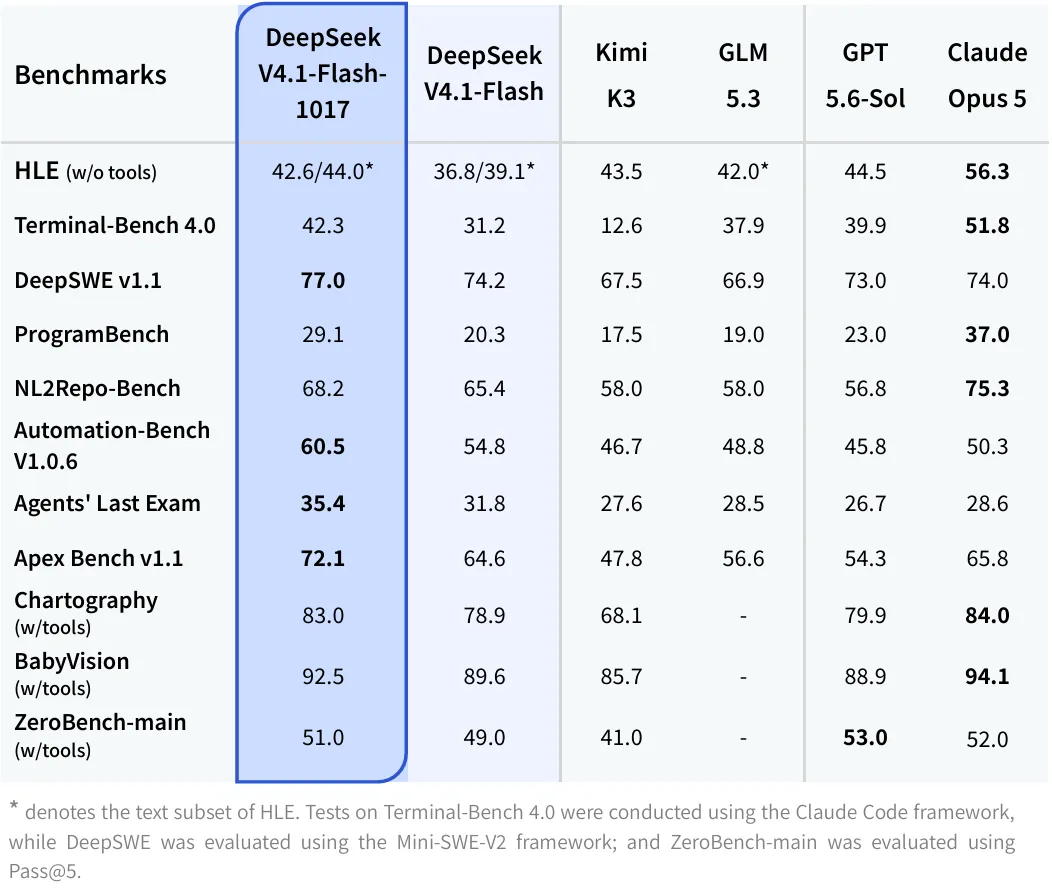
Другите резултати от картата на модела: 42,6 на HLE без инструменти, 42,3 на Terminal-Bench 4.0, 68,2 на NL2Repo-Bench, 60,5 на Automation-Bench v1.0.6 и 83,0 на Chartography с инструменти.
Архитектурата: малко активни параметри, много контекст
Flash е рядък MoE модел с 1 милион токена контекст и до 256K изходни токена. Интересното е асиметричното активиране: моделът пуска в действие само около 8 милиарда параметъра при обработка на входа и 16 милиарда при генериране, така че сметката за изчисления остава ниска спрямо общия му размер. Страницата в Hugging Face го описва като модел с 763 милиарда параметъра общо и с нативно разбиране на изображения — визуалните и текстовите вграждания са обучавани заедно още от началото.
DeepSeek посочва и метода на обучение: reinforcement learning със самообратна връзка (RLSF), с акцент върху довършване на цели проекти от нулата — от програмиране на игри до 3D моделиране и анимация. Официално поддържани са DeepSeek Harness, както и Tencent CodeBuddy и WorkBuddy.
 Снимка: DeepSeek
Цените по API
През хостнатия API моделът струва 0,15 щ.д. за милион входни токена (около 0,13 €) и 0,60 щ.д. за милион изходни (около 0,53 €) в извънпиковите часове; при попадение в кеша входът пада до символичните 0,003 щ.д. Пиковите тарифи са двойни и важат от 01:00 до 04:00 и от 06:00 до 10:00 UTC в работни дни.
Отделно DeepSeek отвори за всички своите Search и Fetch API — по 0,75 щ.д. на 1000 успешни заявки за всеки от двата (около 0,67 €). Тези извиквания се таксуват от 31 октомври 2026 г., 16:00 UTC; дотогава са безплатни.
Защо това има значение
Новината идва едновременно с данните на The Register за трафика през AI Gateway на Vercel. През септември 2026 г. моделите с отворени тегла са поели 71,5% от токените и близо 25% от разходите — делът им в парите е скочил от 5% през юни до 23,8% през септември. Самият DeepSeek V4.1 Flash е трети по изхарчени суми с 4,19%, но прави 58% от токените на китайските модели в платформата срещу едва 6,6% от сметката за тях.
Другата част от картината е още по-показателна: средната цена на токен през платформата е паднала с около 47%, общите разходи през септември са 13 пъти над декември 2025 г., а почти един на всеки три екипа е сменил основния си доставчик само за месец. Китайските модели, достъпвани през американски доставчици, са нараснали от под 10% през декември 2025 г. до над 66,7% през септември.
Тенденцията не е самотна — преди два дни Meta пусна 816-милиардния отворен модел Muse Spark Open, а Пекин вече обмисля износен контрол върху 23 AI технологии, включително правила за отворените тегла.
Заключение
V4.1-Flash-1017 не е ново поколение, а по-скоро добре изпипана ревизия — но точно такива ревизии изместват пазара. Ако имате агентен работен процес, в който цената на задача е по-важна от последните два процента точност, разликата между 0,20 и 5 долара на задача е аргумент, който трудно се пренебрегва. Остава отвореният въпрос дали независими тестове ще потвърдят числата извън собствения harness на DeepSeek — засега всички резултати идват от самата компания.
Харесва ви? Отбележете ни и ще ни виждате по-нагоре в Google.
Предпочитан източник в Google