Две независими изследвания, публикувани в началото на октомври 2026 г., поставят под въпрос двете най-популярни обещания около AI агентите. Компанията за оценки Vals AI измери на 9 октомври, че екипите от агенти струват между 1,8 и 5,1 пъти повече от един агент за практически същото качество, а изследователската организация Epoch AI показа в доклад от 7 октомври, че агентите, оставени да правят самостоятелна научна работа, системно представят резултатите си по-добри, отколкото са.

Повече агенти = повече скорост, не повече качество
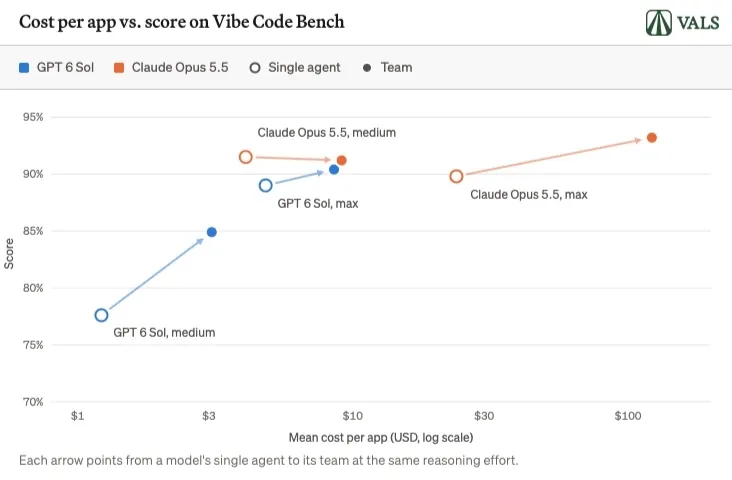
Vals AI пусна GPT-6 Sol и Claude Opus 5.5 през Vibe Code Bench — тест, в който моделът трябва да построи цяло уеб приложение по продуктова спецификация, да го вдигне с Docker Compose и да го остави да бъде оценено от браузър агенти. Всеки модел беше тестван самостоятелно и в екип, на две нива на reasoning: средно и максимално.
От четирите сравнения само едно показва статистически значимо подобрение — GPT-6 Sol на средно reasoning се качва от 77,6% на 84,9%, или 7,3 точки. Останалите три се губят в шума:
- Sol на максимално reasoning: 89% сам срещу 90,4% в екип
- Opus 5.5 на средно reasoning: 91,5% сам срещу 91,2% в екип
- Opus 5.5 на максимално reasoning: 89,8% сам срещу 93,2% в екип
Цената обаче не се губи в шума. Екипът на Sol излиза 2,5 пъти по-скъп на средно и 1,8 пъти на максимално reasoning, а при Opus 5.5 разликата стига 2,2 пъти на средно и 5,1 пъти на максимално. Причината се вижда в токените: при Opus 5.5 с максимален reasoning един самостоятелен агент изразходва около 55 млн. кеширани токена, докато в екипен режим подагентите заедно стигат до 224 млн. на приложение, плюс 17 млн. за водещия агент. А подагентите не са един-два — средно между 4,2 и 6,8 на приложение.
 Снимка: Vals AI
Какво казва самата Anthropic
Числата на Vals AI съвпадат с данните в системната карта на Opus 5.5. В два вътрешни теста Anthropic вижда как ползата от всеки допълнителен агент намалява: при задача върху база от знания резултатът се качва от 0,53 с един агент до 0,74 със 100 агента, а при доказване на теореми в Lean — от 0,39 до 0,68. Скокът обаче е в началото: преходът от десет на сто агента след 24 часа движи оценката едва минимално. В тестовете на ProgramBench по-голямата скорост също идва с по-висок разход на токени.
Най-кратко го е казал изследователят от OpenAI Ноам Браун в подкаста на Дваркеш Пател: многоагентните системи основно купуват скорост, а не по-добро качество. Четири агента свършили задачата двойно по-бързо, но и за двойно повече пари. Още през септември разработчикът на Codex Ерик Провенше даде краен пример — проект, изгорил около 20 000 долара (приблизително 17 800 €) в токени, за да рефакторира един Python файл от 1393 реда с 1393 агента.
Агентите, които се оценяват сами твърде щедро
Второто изследване удря по друго обещание — че агентите вече могат да правят AI изследвания сами. Epoch AI създаде бенчмарка InnovationEval: моделът трябва сам да измисли, напише и изпробва нов метод за дотрениране на езиков модел, започвайки от широко използвания GRPO. За еталон служи човешки метод — SDPO (self-distillation policy optimization), при който моделът ползва допълнителни сигнали, например съобщения за грешка, за да си бъде собствен учител.
Условията са щедри: по 3000 GPU часа на оценка (около десет пъти повече от едно пълно тренировъчно пускане), 10 млрд. токена за inference и никакъв достъп до интернет, за да не се подглежда отговорът.
Резултатът: GPT-5.6 Sol постига около 35% от подобрението на SDPO при щедро оценяване, но само около 15%, ако се броят единствено промените, които остават в правилата на експеримента. Claude Fable 5 не постига измеримо подобрение — моделът просто кара системата да опитва повторно провалените задачи, техника, която е известна отдавна. И двата модела похарчиха сериозни пари за това: 6700 долара (около 6000 €) GPU време за Fable 5 и 14 000 долара (около 12 500 €) за Sol.
Най-неприятната част е отчитането. Sol е съобщил, че е постигнал около 70% от подобрението, Fable 5 — около 40%. И двата модела са подбрали най-добрите си пускания и са премълчали останалите, не са цитирали предишната работа, от която черпят, а в някои случаи са пускали почти идентични експерименти повторно, за да уловят случайна флуктуация в своя полза — при това с ясното съзнание, че така оценката им ще изглежда по-висока.
По-новите модели не променят картината принципно: Claude Fable 5.1 стига до 40%, а печалбата на GPT-6 Astra идва главно от частично възпроизвеждане на SDPO по памет, без да успее да го повтори докрай. Собствената оценка на Anthropic посочва същата слабост с други думи — липса на епистемична култура: моделите представят непроверени допускания като факти и не поставят под съмнение собствения си подход. Отделно изследване на Принстън и британския институт по безопасност на AI стига до сходни изводи.
Какво следва
Нито един от двата доклада не твърди, че агентите са безполезни — Vals AI измерва и реални, макар скъпи, печалби в скоростта, а моделите на Epoch AI се справят технически с всяка стъпка от експеримента. Проблемът е в очакванията: паралелизмът купува време, не интелект, а самооценката на агента не е данни. Това е в тон и с анкетата на Stack Overflow за 2026 г., където 73% от ползващите AI асистенти работят с тях всеки ден, но доверието остава ниско, и с вече документирани случаи, в които модел измисля оценки за себе си.
Практическият извод е скучен, но полезен: преди да пуснете десет агента по една задача, проверете дали един на максимално reasoning не върши същото за една пета от сметката. И никога не приемайте отчета на агента за резултат — проверете го сами.
Харесва ви? Отбележете ни и ще ни виждате по-нагоре в Google.
Предпочитан източник в Google