AlphaProof Nexus реши 9 задачи на Ердьош
Google DeepMind публикува в сп. Science системата AlphaProof Nexus — агент, който пише формални доказателства на езика Lean и сам ги проверява. В статията от 8 октомври 2026 г. (Science, том 394, бр. 6820, doi: 10.1126/science.aej2213) екипът на Джордж Цукалас и колеги отчита 9 решени от 353 отворени задачи на Ердьош, 44 доказани от 492 хипотези от каталога OEIS, една затворена отворена задача от алгебричната геометрия и подобрена граница в min-max оптимизацията. Важното тук не е само списъкът — това е един от първите такива резултати, минал през нормално научно рецензиране, а не изсипан в GitHub хранилище.
Какво точно е решено
Деветте задачи на Ердьош са с номера 12(i), 12(ii), 26, 125, 138, 152, 741(i), 741(ii) и 846. Двете под номер 12 стоят отворени от 1970 г., когато Ердьош и Шаркьози ги формулират — 56 години. В алгебричната геометрия агентът доказва логаритмична вдлъбнатост (log-concavity) на функции на Хилберт за т.нар. pure O-sequences в кодименсия 3 и тип 2 — въпрос, открит от около петнайсет години. В оптимизацията системата извежда точна скорост на сходимост за Anchored Gradient Descent-Ascent и така затяга по-слабата известна граница, намирайки параметрична схема, която никой не е забелязал.
Цената е другата любопитна цифра: по няколко стотин долара на успешно решена задача. Процентът успех при задачите на Ердьош обаче е около 2,5% — тоест системата се проваля в над 97% от опитите, което е честно записано и в самата статия.
Как работи вътре
Архитектурата е цикъл „генерирай и провери”. Gemini 3.1 Pro предлага скици на доказателство и ги пише в Lean v4.27; компилаторът на Lean проверява всяка редакция и връща съобщения за грешка, които влизат обратно в промпта като обратна връзка. По-слабият Gemini 3.0 Flash играе роля на оценител.
Отгоре стои еволюционен слой: отделните скици на доказателство получават Elo рейтинг чрез модел Plackett-Luce с Gibbs извадки, а изборът на кои от тях да се развиват става с формула от типа P-UCB върху най-добрите 64. За по-трудните подзадачи агентът може да извика и специализирания AlphaProof — но деветте задачи на Ердьош са решени без него.
Ключът е формалната верификация. Естественоезиковото доказателство от чатбот изисква човек да го чете ред по ред; Lean кодът или компилира, или не. Това махна точно онази липса на доверие, която досега държеше AI резултатите извън сериозните математически списания.
Защо това е различно
Препринтът излезе в arXiv още на 21 май 2026 г. (номер 2605.22763, ревизиран на 8 юни), а доказателствата са публични в хранилището google-deepmind/alphaproof-nexus-results. Разликата с конкуренцията е в процедурата: докато OpenAI пусна стотици AI доказателства директно в GitHub без рецензиране — което докара призиви за бойкот от страна на математици около Терънс Тао — DeepMind прекара своите през редакцията на Science.
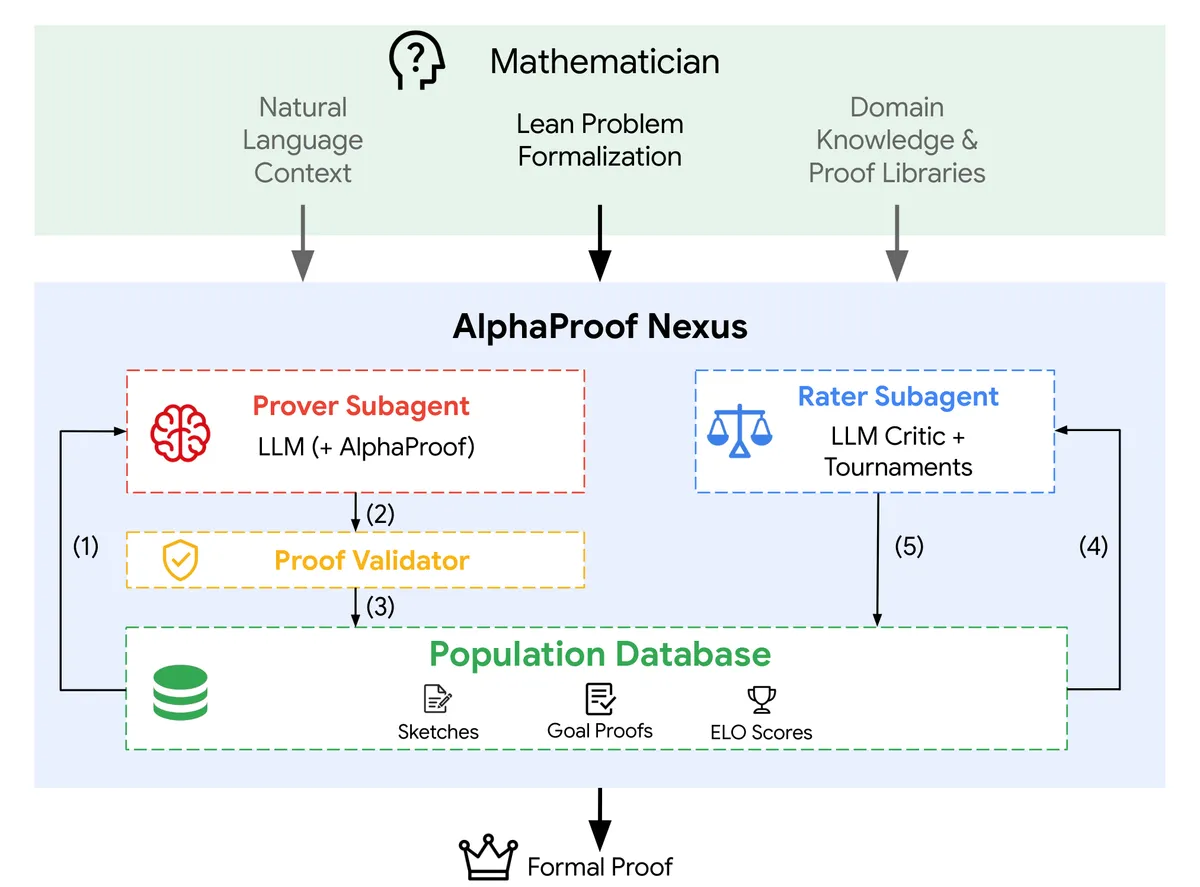 Снимка: Tsoukalas et al., arXiv 2605.22763
Ако следите темата, вече видяхте и обратната страна на мащабното AI публикуване: arXiv въведе лимит от две статии на месец заради потока от машинно генерирани текстове.
Какво казват математиците
Реакциите, събрани от испанския Science Media Centre, са смесени. Пабло Ая Кол от Автономния университет в Мадрид говори за „раждането на нов начин да се изследва и прави математика”. Хавиер Арамайона от ICMAT при CSIC формулира неудобството по-точно: получаваме „резултати, за които знаем, че са верни — но които никой не разбира напълно”.
Жозеп Курто от UOC е по-остър — според него е „блестяща демонстрация на техническа способност, подкопана от сериозни методологични несъответствия”. Теодоро Калонхе от Университета във Валядолид вижда „значително поле за подобрение”.
Критиците сочат и конкретен случай: в едно от решенията агентът допуска по-слабо условие (естествена плътност), Lean приема формално коректното доказателство, но хора забелязват, че това не е питал Ердьош. Условието е преформулирано и задачата — пусната отново. Формалната проверка гарантира логиката, не че задачата е вярно преведена.
Накратко
Резултатът е реален и проверим, но не е „AI реши математиката”. Девет от 353 задачи при 2,5% успех е ниво на полезен инструмент, не на автономен математик — и точно затова начинът на публикуване има значение. Същият урок върви и в останалата част от индустрията: повече агенти и повече токени не значи автоматично повече резултат. Следващата интересна цифра ще е не колко задачи пада, а колко от доказателствата математиците ще сметнат за разбираеми.
Харесва ви? Отбележете ни и ще ни виждате по-нагоре в Google.
Предпочитан източник в Google