
Технологични компании изкупуват стари печатни книги на палети, отрязват подвързиите им, прекарват листовете през високоскоростни скенери и изхвърлят хартията — всичко това, за да получат „чист” текст за обучение на езикови модели. Tom’s Hardware обобщава поредица от репортажи и съдебни документи, според които поръчките минават през посредници, които пазят анонимността на купувача. Антиквари в Германия, Испания, Швейцария и Нидерландия съобщават за странно големи поръчки от пролетта насам.
Как работи конвейерът
Схемата е индустриална и учудващо проста. Стандартен палет побира между 800 и 1200 книги, а типичните партиди при големите купувачи стигат до 10 000 тома. Гилотина или хидравлична машина отрязва гръбчето, след което така наречените деструктивни скенери обработват по 80 до 120 страници в минута — те са по-бързи и в пъти по-евтини от щадящите скенери, при които някой обръща страниците на ръка. Накрая нарязаната хартия отива за рециклиране.
Посредникът, който се появява най-често в разследванията, е базата данни ISBNdb. Тя приема поръчки от хиляда до милион заглавия, крие самоличността на клиента и предлага споразумения за неразгласяване. В маркетинговите ѝ материали има фраза, която обобщава целия бизнес: „Най-добрите данни за обучение на AI в света стоят на един рафт.” Има и трезво признание за имиджовия риск — „AI компания унищожава два милиона книги” не е заглавие, което печели симпатии.
Изкупуването се автоматизира с флагове за автоматична покупка по ISBN списъци в платформи за втора употреба като Alibris и Biblio. Търсят се предимно книги отпреди 2022 г. Причината е техническа: текст, писан гарантирано от хора, е застраховка срещу „model collapse” — влошаването на моделите, когато се обучават върху собствения си синтетичен изход.
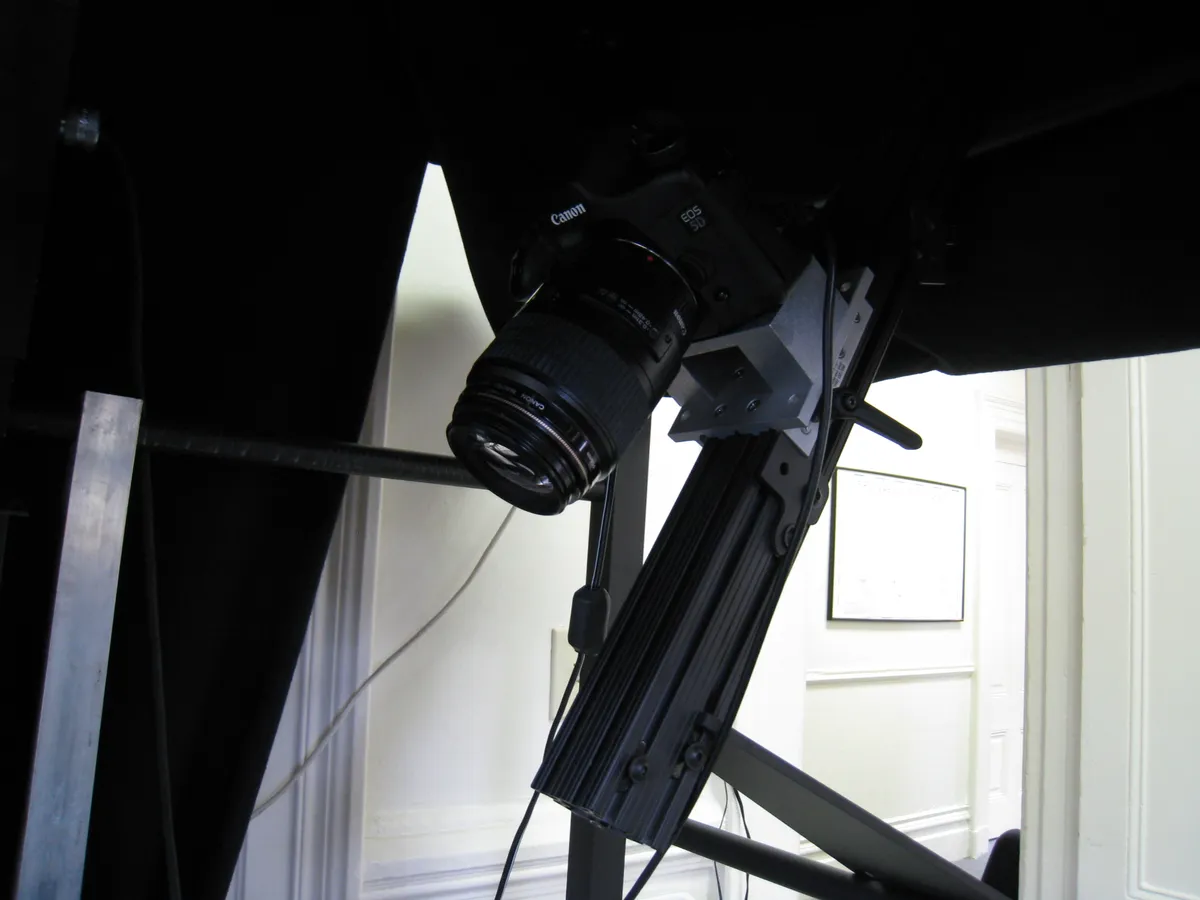 Снимка: Dvortygirl / Wikimedia Commons (CC BY-SA)
Защо се стигна дотук: делата за пиратските библиотеки
До 2023–2024 г. пътят беше друг. Моделите се хранеха с Books3, LibGen и Z-Library — колекции с десетки хиляди до милиони пиратски книги. Именно тези набори доведоха до вълната искове от автори и издатели.
Ключът е решението по делото Bartz срещу Anthropic. През юни 2025 г. федералният съдия Уилям Алсъп от Северния окръг на Калифорния постанови разделителна линия: обучението на модел върху книги, купени законно и сканирани от компанията, е „честна употреба”, защото е силно преобразуващо и защото при деструктивното сканиране остава едно копие вместо две. Съхраняването на централна библиотека от пиратски файлове обаче не е. Anthropic плати 1,5 млрд. долара по споразумение за около 500 000 произведения.
Изводът, който индустрията си направи, е прагматичен: купувай хартия, режи, сканирай, изхвърляй. От документи по делото и от разследване на The Washington Post стана известно и вътрешното име на програмата на Anthropic — Project Panama, описана като „усилието ни деструктивно да сканираме всички книги на света”. За целта компанията нае Том Търви, бивш ръководител на партньорствата в Google Books, а офертата на изпълнителя Datamation говори за 500 000 до 2 милиона тома за шест месеца. Това е втората голяма проверка тази година върху веригата на доставки на обучаващи данни след разследването за nudify моделите в Hugging Face.
Тревогата на антикварите и библиотекарите
Проблемът не е в масовите тиражи — един джобен трилър от 1998 г. има десетки хиляди копия. Проблемът са редките и извън печат изданията. Нидерландският търговец Питер де Врис от De Vries & De Vries в Харлем е получил запитване за близо 3000 заглавия от фирма със седалище в Сингапур. Малки книжарници отчитат скок от около 20 продадени книги седмично до стотици. Част от тези тиражи са в няколко десетки оцелели екземпляра, а купувачът няма задължение да върне сканираното копие на обществото — то влиза в затворен корпус за обучение, а хартията изчезва.
Библиотекари и антиквари подчертават и че никоя федерална агенция, библиотечна или образователна асоциация в САЩ засега не е издала публично указание по въпроса. Тоест липсва механизъм, който да отсее „последното известно копие” от палета.
Стилът, Делхи и правилата в ЕС
Паралелно тече втора линия — правата върху стил. Engadget провери и установи, че ChatGPT вече отказва да пише в стила на известни автори, включително покойни. На молба за нещо в духа на Агата Кристи ботът отговаря, че творбите ѝ са още под закрила и той не може да имитира отблизо отличителния ѝ стил — но предлага да напише оригинален текст със същите характеристики. По-скоро дисклеймър, отколкото твърда забрана, но показва накъде духа вятърът при исковете срещу OpenAI.
В обратната посока е Индия. На 24 юли Висшият съд в Делхи, чрез съдия Амит Бансал, отхвърли искането на агенция ANI за временна забрана срещу OpenAI, пише the-decoder. Доказателствата на ANI се обърнаха срещу нея — цитираните статии са от август–септември 2024 г., а GPT-4 и GPT-4o имат данни съответно до април 2022 и април 2024 г. Съдът прие, че обучението попада в изключението за лично ползване и изследване, ако източниците са законни и копията остават вътрешни.
За авторите и издателите в България и ЕС най-практичната лоста остава AI Act. По чл. 53(1)(г) доставчиците на модели с общо предназначение трябва да публикуват обобщение на обучаващото съдържание по задължителния образец, който Службата по ИИ издаде на 24 юли 2025 г. Задължението важи от 2 август 2025 г., а моделите, пуснати преди тази дата, имат срок до 2 август 2027 г. В обобщението влиза и описание как е спазен opt-out по изключението за text and data mining. Спорът за отворените тегла и достъпа до данни, който вече противопостави Амодей и Хуанг, тук получава съвсем осезаемо измерение.
Какво следва
Решението по Bartz превърна купуването на хартия в най-безопасния юридически маршрут, а пазарът реагира точно както се очаква от пазар — с палети и гилотини. Ако сте автор или издател в ЕС, следете обобщенията по AI Act: те са единственият документ, който може да покаже дали вашето заглавие е минало през скенера. Ако търгувате с антикварни книги, струва си да питате за какво отиват 3000 тома, преди да ги изпратите.
Харесва ви? Отбележете ни и ще ни виждате по-нагоре в Google.
Предпочитан източник в Google