Google продава TPU чипове, Meta вече ги ползва
Десет години Google държеше своите TPU чипове само за себе си — ползваха се единствено в сървърите на Google и се наемаха по час през Google Cloud. Това вече не е така. На 20 октомври 2026 г. Google обяви, че TPU-тата му работят и извън собствената му инфраструктура, а първият голям външен клиент е Meta. Tom’s Hardware описва хода като първата реална заплаха за доминацията на Nvidia при ускорителите за AI.
Какво точно обяви Google
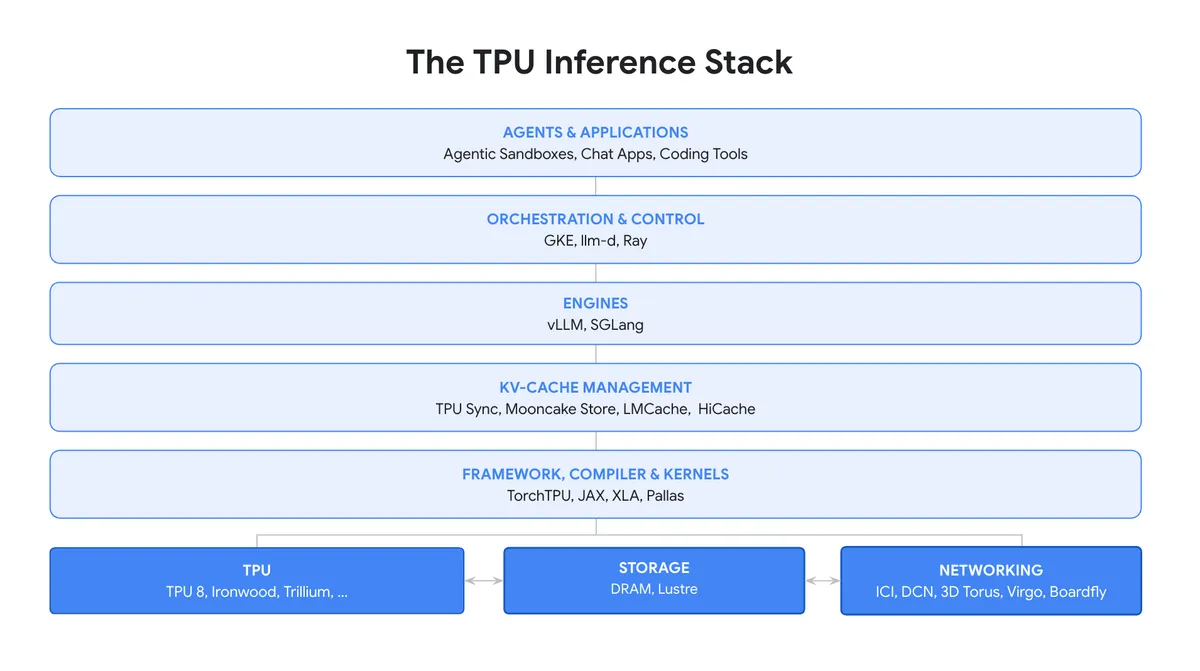
Поводът е пускането на TorchTPU като open source — native PyTorch стек за TPU, разработен съвместно с екипа на PyTorch в Meta. Заедно с него Google пусна и два inference engine-а: vLLM-TorchTPU (с Inferact) и SGLang-TorchTPU (с RadixArk, основана от създателите на SGLang).
Важното е в едно изречение от блога на Google за разработчици: SGLang-TorchTPU „работи в production при Meta днес“. Цитатът е на Zongwei Zhou, който води PyTorch-TPU направлението в Meta, и описва стека като „забележително зрял, PyTorch-native“ и вграден в съществуващата инфраструктура на компанията.
Jana van Greunen, директор „PyTorch инженеринг“ в Meta, обяснява мотива по-директно в съобщението на Google Cloud: „Не можем да сме ограничени от една хардуерна архитектура.“ По думите им TorchTPU покрива натоварвания за големи езикови модели, реклами и системи за препоръки — тоест не експеримент, а продуктова част от бизнеса.
 Снимка: Google Developers Blog
Числата
Google публикува и конкретни резултати, повечето върху Ironwood — седмото поколение TPU (TPU v7x), което дава 4,6 petaFLOPS на чип и до 42,5 exaFLOPS в superpod от 9216 чипа:
- 52% MFU (model flops utilization) при Qwen 3 8B, с почти линейно скалиране до 8192 Ironwood чипа;
- 2,01 US цента за милион токена при Qwen 3.5 на Ironwood — Google твърди, че това е най-ниската цена в индустрията (около 1,8 евроцента);
- над 700 токена в секунда за един потребител при Kimi K3, благодарение на Pallas megakernel от Inferact;
- 4 пъти по-висока пропускливост при Zenteiq — от 1,47 на 5,97 милиарда токена на ден на всеки 1000 ускорителя TPU v6e.
Ако тези цифри се потвърдят и при други клиенти, сметката за inference става съвсем различна. За сравнение, прогнозите за разходи за чипове за inference от Nvidia през 2026 г. са 40–50 млрд. долара — пазар, в който досега почти нямаше алтернатива.
Защо Meta
Връзката между двете компании не е нова. През август 2025 г. Meta подписа шестгодишен договор за над 10 млрд. долара за сървъри и storage в Google Cloud, а по-късно добави и многогодишно наемане на TPU капацитет. Планът за покупка на чипове, които да влязат в собствените дата центрове на Meta, се очакваше за 2027 г. — обявеното сега изпреварва графика.
Причината е проста: Meta има нужда от всеки свободен ускорител. Писахме как над 11% от GPU-тата в суперкластера Prometheus стоят в резерв заради прекъсвания и охлаждане. Второ, диверсификацията намалява зависимостта от един доставчик — а Google Cloud вече предлага и моделите на OpenAI и Anthropic наред с Gemini, така че платформената неутралност явно работи в двете посоки.
Как Meta плаща за това
Ден по-късно — 21 октомври — Meta отчете третото тримесечие на 2026 г. и показа цената на цялата тази инфраструктура. Приходите са 64,6 млрд. долара, с 26% повече на годишна база, но разходите растат с 68%. Капиталовите разходи само за тримесечието са 34,91 млрд. долара, а свободният паричен поток е отрицателен — минус 2,12 млрд. Прогнозата за годишен capex беше свита нагоре до 135–145 млрд. долара.
Отговорът на Meta е нов клас акции. Според TechCrunch компанията създава публично търгуван Class C без право на глас, в сила от 19 януари 2027 г. Всички настоящи акционери получават по една Class C акция за всяка притежавана — на практика сплит два за един. Финансовият директор Susan Li определи новите акции като използваеми за набиране на капитал, възнаграждения на служители и придобивания. Контролът на Марк Зукърбърг върху гласовете остава непокътнат. The Verge определя хода като пряк начин да се плати AI експанзията.
За контекст: Reality Labs ще загуби между 18 и 19 млрд. долара през 2026 г., а AI агентът Muse е минал 10 милиона потребители в САЩ и Канада за месец и половина.
Какво следва
Най-интересното в тази новина не е сделката, а стекът. Докато TPU-тата се наемаха само през Google Cloud, преносимостта не беше проблем на клиента. Сега, когато чиповете влизат в чужди дата центрове, Google трябваше да махне най-голямата бариера — CUDA. TorchTPU и двата native backend-а за vLLM и SGLang са точно това: начин да смените .to("cuda") с .to("tpu"), без да пренаписвате инфраструктурата си.
Дали това ще промени пазарните дялове през 2027 г., ще се види по следващите поръчки. Но за първи път от години голям купувач на ускорители има реална втора опция — и тя вече работи в production.
Харесва ви? Отбележете ни и ще ни виждате по-нагоре в Google.
Предпочитан източник в Google