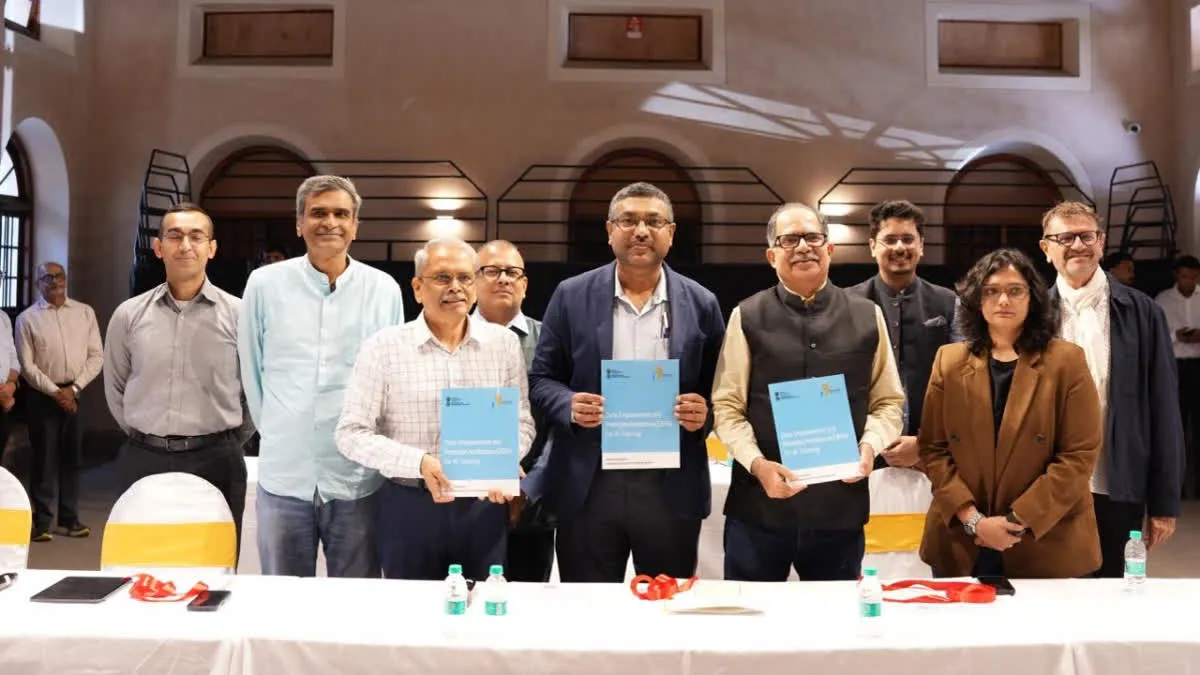
Индийското министерство на електрониката и информационните технологии (MeitY) публикува на 31 октомври 2026 г. наръчник за нова рамка за обучение на AI модели, в която данните никъде не се местят. Принципът го формулира главният научен съветник на индийското правителство проф. Аджай Кумар Сууд: „при DEPA моделът пътува до данните, вместо данните да пътуват до модела“. Документът беше представен на кръгла маса в Бенгалуру от секретаря на MeitY С. Кришнан, с подкрепата на фондацията iSPIRT, пише The Register.
Рамката се нарича DEPA — Data Empowerment and Protection Architecture — и е достъпна като PDF на сайта на MeitY с изрично уточнение, че е „чернова за обсъждане“ и жив документ.
Как работи „запечатаната стая“
Схемата има три основни роли. Доставчиците на данни за обучение (Training Data Providers) са болници, банки и държавни агенции, които регистрират набори от данни. Платформите за обмен (Data Exchange Platforms) хостват т.нар. hardware-based Secure Data Environments — средата, в която данните остават криптирани и по време на обработка. Потребителите на данни (Training Data Consumers) са стартъпите, изследователите и компаниите, които искат достъп.
Разрешенията се описват в машинно четими договори, обвързани с конкретна цел. Разработчикът качва своя модел или задача за обучение в защитената среда на притежателя на данните, обучението се изпълнява там и навън излиза само резултатът. Суровите записи не напускат институцията.
Отгоре MeitY слага два пласта защита: диференциална приватност, която добавя статистически шум, за да не може моделът „да научи или разкрие информация за конкретен човек“, и неизменяем журнал на достъпа. Рамката предвижда и проследимост на произхода — откъде е дошъл всеки набор от данни, с какви разрешения и за какво е ползван.
Около тази основа се описват още два слоя: „Data Collabs“ — посредници, които обединяват и стандартизират данни от няколко източника, и индустриалната организация Samyog, която да поема регистрацията, договорите и споровете.
Какво вече е тествано
Числата от първите пилоти са скромни, но конкретни. В банковия сектор банка е обработила над 2 милиона заявки за допустимост за кредитна карта върху данни на финтех партньор в рамките на две седмици, без да види данни на клиенти. В здравеопазването болници са обучили модел за откриване на тумори върху MRI изображения, до които стартъпът разработчик не е имал пряк достъп.
Амбициите са значително по-големи. MeitY говори за потенциал от 500 млрд. долара добавена стойност за индийския БВП до 2030 г. (приблизително 430 млрд. евро), за включване на 400 милиона хора и микро- и малки предприятия във формалната кредитна система и за приложения в образованието при 250 милиона ученици.
Отворените въпроси
Наръчникът не е закон. Обвързващите правила се очакват от секторните регулатори, а не от ново законодателство, и графикът е вързан към влизането в сила на индийския Digital Personal Data Protection Act през май 2027 г.
Два въпроса остават без отговор и в самия документ: как се плаща на притежателя на данните и кой носи отговорност, ако „запечатаната стая“ все пак протече. Това е съществено — моделът на DEPA прехвърля риска от трансфера на данни към риска от изпълнение на чужд код в чужда среда, което не е същият проблем, но също не е решен проблем.
Съоснователят на iSPIRT Шарад Шарма сравни момента с обявяването на UPI през февруари 2016 г. Сравнението е оптимистично: UPI тръгна с ясен регулатор и ясен бизнес модел за участниците, каквито DEPA още няма.
Защо това се случва точно сега
Контекстът е суверенитетът над данните. Индия има огромни набори от чувствителни данни — здравни, финансови, образователни — които днес или стоят заключени, или излизат към чужди платформи. Моделът „моделът идва при нас“ е опит и двете да се избегнат. Държавата го представя и като принос към „научната дипломация“ — инициативи на Световната банка и ООН за по-приобщаващо развитие на AI.
Паралелно Европа върви по друг път към същата цел — собствена инфраструктура. Урсула фон дер Лайен потвърди, че Канада се присъединява към мрежата на EuroHPC Joint Undertaking: 14 суперкомпютъра, 10 квантови машини и 19 AI фабрики, при бюджет на съвместното предприятие от 8,2 млрд. евро. Поканата за до седем AI гигафабрики е с краен срок 12 ноември 2026 г. и комбинира до 10 млрд. евро публична подкрепа с поне 20 млрд. евро частни инвестиции. Европа строи мястото, където да дойдат данните; Индия предлага данните да останат там, където са. Тук сме писали и за 319 млн. евро европейска помощ за GaN чипове — част от същата логика на технологична независимост.
Заключение
DEPA за AI обучение е интересна като архитектура, не като готов продукт. Ако проработи, тя обръща икономиката на данните: институцията запазва актива си и продава достъп до изчисление върху него, вместо да се разделя с него — обратното на случаи като продажбата на данни за шофьори от GM. Дотогава остават три неизвестни: цената, отговорността и дали регулаторите в здравеопазването и финансите ще признаят „запечатаната стая“ за достатъчна защита. Следващата конкретна дата е май 2027 г.
Харесва ви? Отбележете ни и ще ни виждате по-нагоре в Google.
Предпочитан източник в Google