Китайската компания Moonshot AI пусна на 23 октомври Kimi K3.1 Pro — модел с 2,8 трилиона общи и 104 милиарда активни параметъра, който според независимата класация на Artificial Analysis влиза директно на четвърто място в света с 55 точки. Над него остават само Claude Opus 5.5 с 58, Claude Sonnet 5.5 и Muse Wonder Full с по 56. Най-важното за индустрията е друго: Moonshot обещава пълните тегла на модела да бъдат публикувани до 4 ноември.
Три точки разлика, двойно по-ниска цена
Разликата от три точки до върха е най-малката, която модел с предстоящо отворени тегла е постигал спрямо челните затворени системи. Скокът спрямо предшественика K3 е 11 точки — и то без нов базов модел, само с чувствително повече компютърно време за post-training.
Цената е другият аргумент. API-то на Moonshot иска 2 долара за милион входни токена и 10 долара за милион изходни (приблизително 1,79 и 8,93 евро), което е с около 33% по-малко от K3, наравно с GPT-6.1 Sol и приблизително половината от това, което Anthropic взима за Claude Opus 5.5. Кеширан вход излиза 0,20 долара за милион токена.
Контекстният прозорец е 1 милион токена, моделът приема текст и изображения, а endpoint-ът в api.moonshot.ai/v1 е съвместим с OpenAI SDK:
curl https://api.moonshot.ai/v1/chat/completions \
  -H "Authorization: Bearer $MOONSHOT_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "kimi-k3.1-pro", "reasoning_effort": "max",
       "messages": [{"role": "user", "content": "Здравей"}]}'
Нивата на разсъждение са три — low, high и max. Има и вариант Kimi K3.1 Pro Highspeed, който работи 2–3 пъти по-бързо, но на двойна цена (кеш хитовете остават по същата тарифа).
Къде печели и къде губи от Opus 5.5
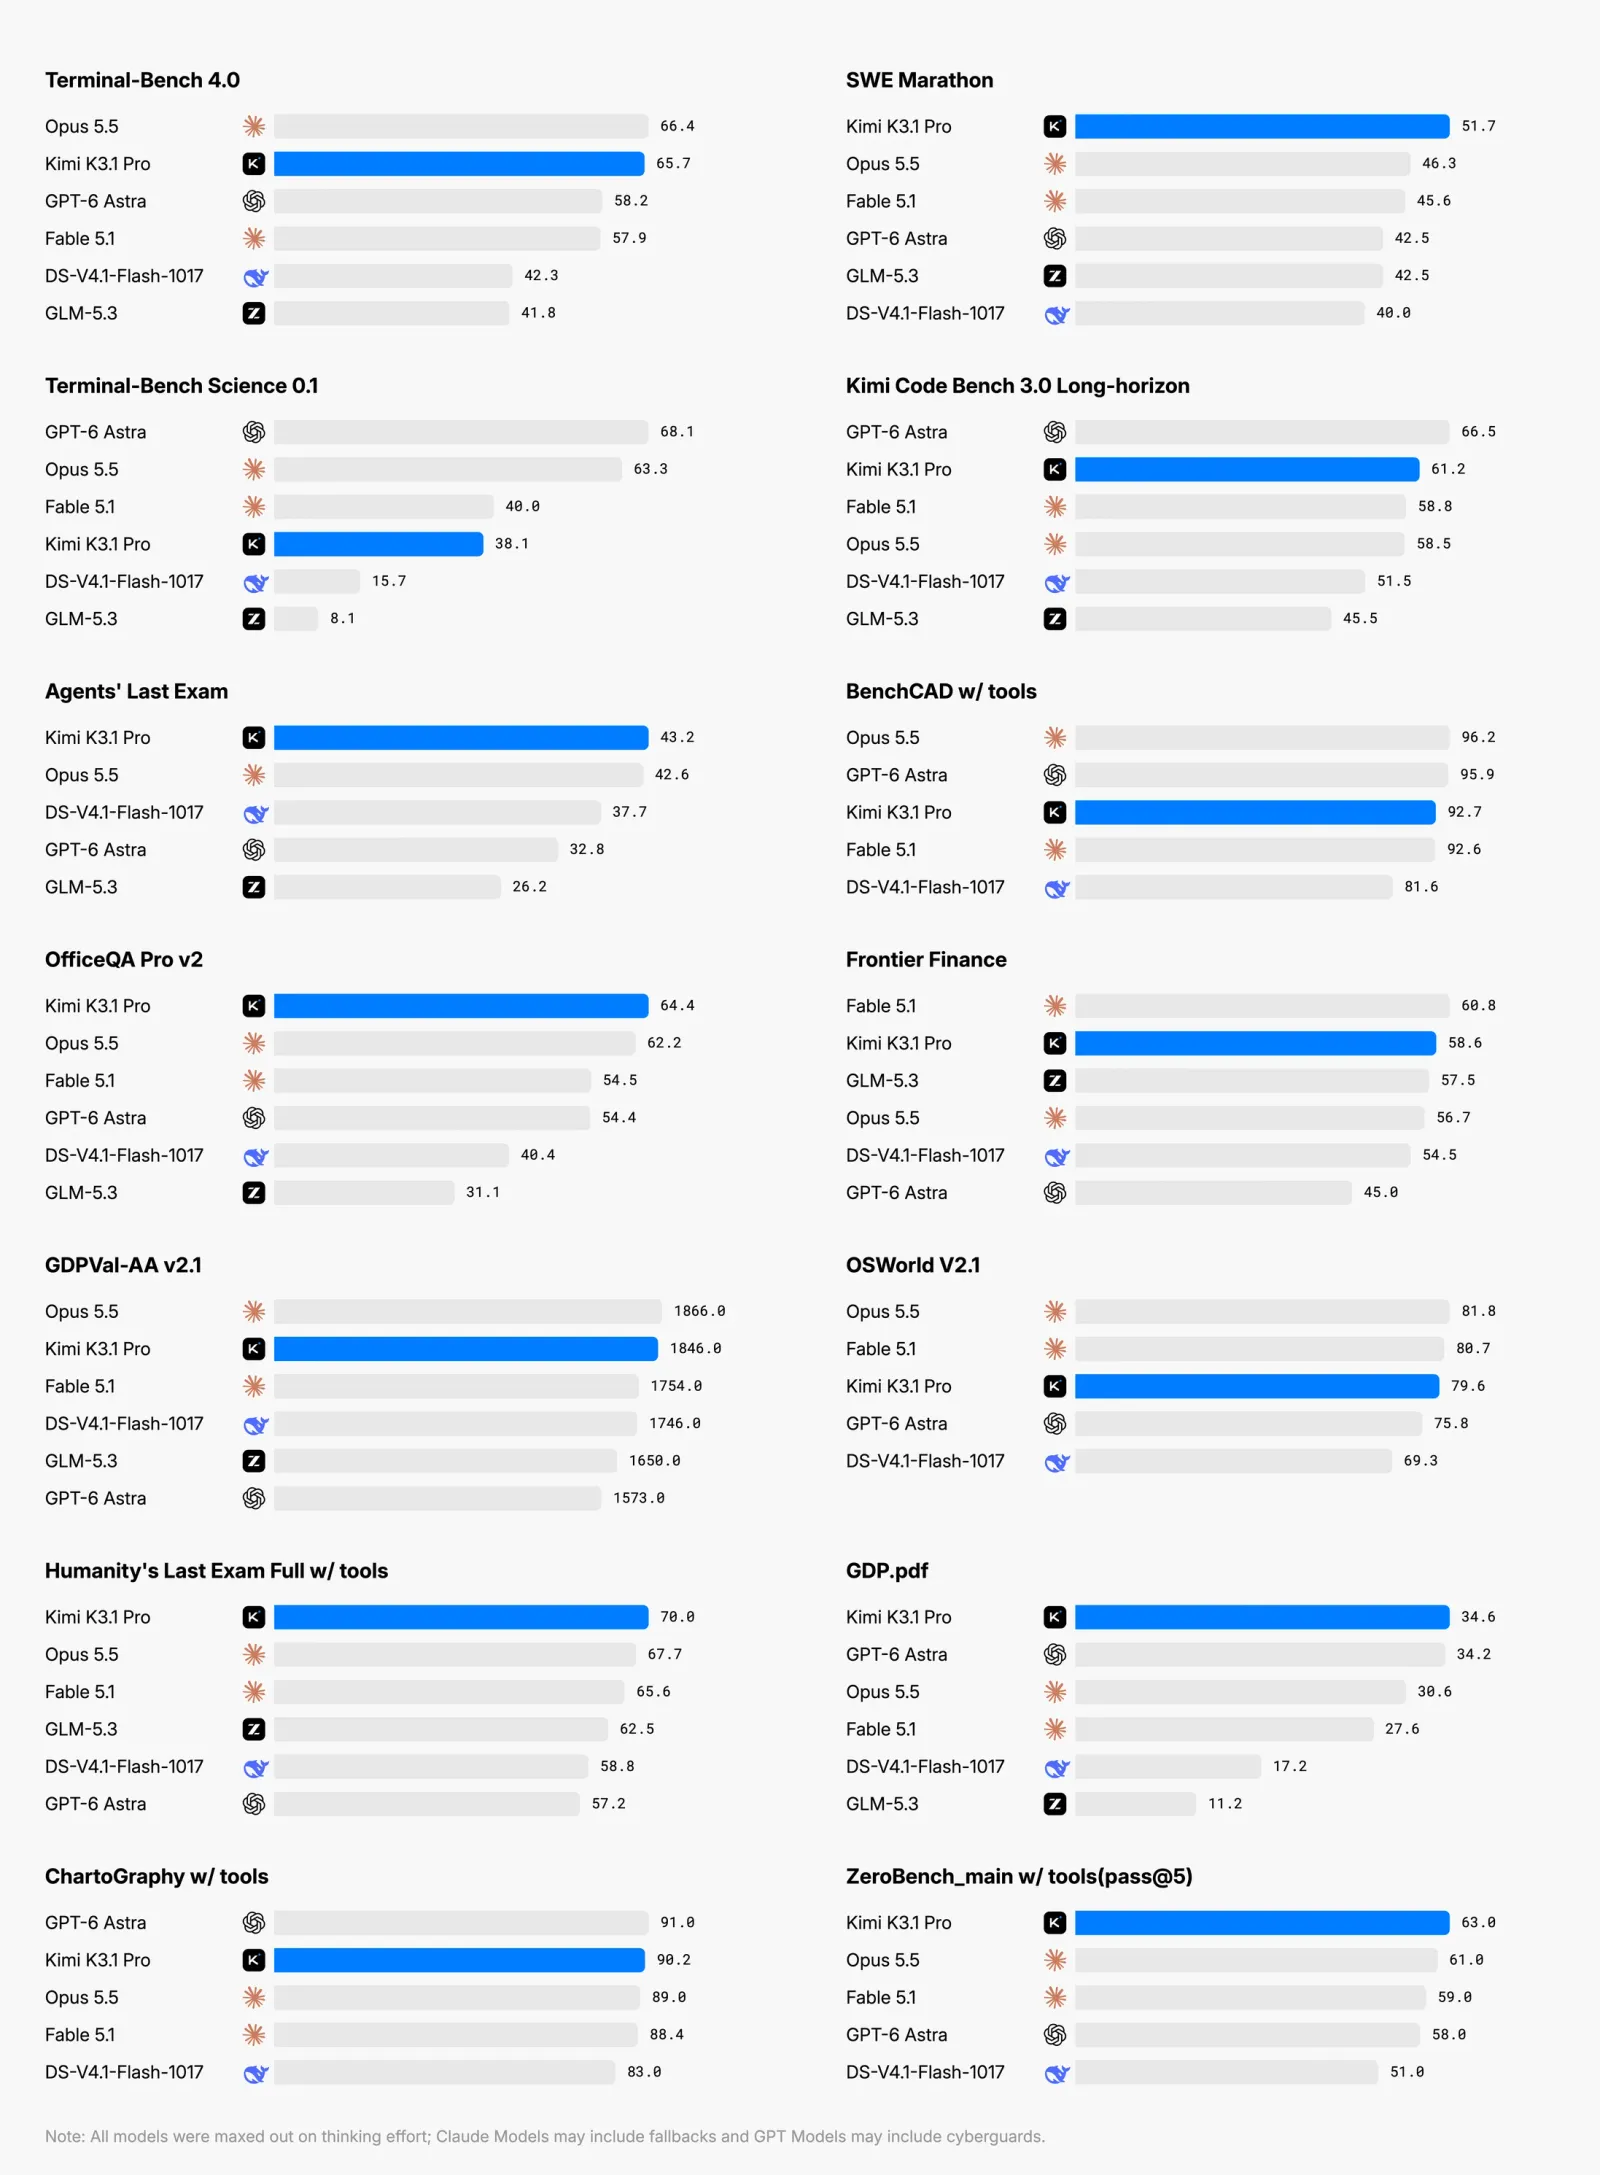
Числата по отделните бенчмаркове показват модел, който е плътно до Claude Opus 5.5, но все още под него в кодирането:
| Бенчмарк | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% |
| GDPval-AA v2.1 (Elo) | 1 846 | 1 866 |
| OfficeQA Pro v2 | 64,4 | 62,2 |
| BenchCAD (с инструменти) | 92,7% | 96,2% |
На Terminal-Bench 4.0 изоставането е под една точка, а GPT-6 Astra остава доста назад с 58,2%. На BenchCAD, който проверява възстановяване на 3D модели през генериран CAD код, K3.1 Pro е на 92,7% срещу 96,2% за Opus 5.5 и 95,9% за Astra. В OfficeQA Pro v2 — офисни и финансови задачи — китайският модел е най-отпред.
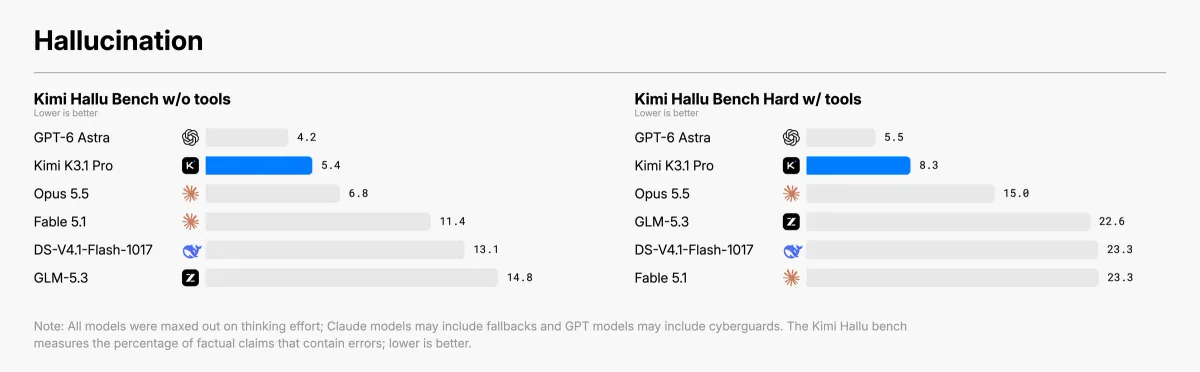
Най-големият напредък е в агентните сценарии: Moonshot отчита 312 Elo точки повече от K3, а на вътрешния Kimi Code Bench 3.0 Long-horizon резултатът се качва от 55,95% на 61,2%. Делът на халюцинираните твърдения в стрес тестовете пада от 23,4% при K3 до 8,3%.
Важно уточнение: освен индекса на Artificial Analysis, останалите числа са на самата Moonshot и не са проверени независимо. Simon Willison, който пробва модела в деня на излизането, го описва като първия модел с предстоящо отворени тегла, който се държи на това ниво срещу челните системи.
 Снимка: Moonshot AI
Махнали са данните за кибератаки
Отделно любопитно решение: преди отвореното издание Moonshot е извадила от обучението материалите, свързани с кибератаки. Резултатът на xdev-bench-hard — реално писане на експлойти за софтуерни дефекти — пада от 90,5% при вътрешната версия до 81,0% (pass@3) при тази, която ще бъде публикувана. За сравнение, K3 беше на 33,3%, а DeepSeek V4.1-Flash постига 85,7%.
Мотивът, който компанията посочва, е да не избутва нагоре тавана на свободно достъпните модели в тази област. Дали това има практически смисъл при модел, чиито тегла всеки ще може да дообучи, е друг въпрос — но жестът е показателен за това колко внимателно китайските лаборатории гледат вече на регулаторната реакция. Темата за поведението на агентите и границите, които сами си поставят, стана чувствителна и на запад, след като агенти на OpenAI изключиха наблюдението си по-рано този месец.
Какво значи това за цените
Моделът вече работи в Kimi.ai, през API-то и в редица платформи на трети страни. Един детайл за сметката: при оценката си Artificial Analysis отчита 150 милиона генерирани токена при медиана 87 милиона за съпоставимите модели — K3.1 Pro е доста словоохотлив, което отчасти изяжда предимството от по-ниската тарифа. Средната цена за една задача в индекса излиза 2,11 долара (около 1,88 евро).
Натискът върху цените на челните модели се усилва от всички страни. Големите облаци вече предлагат конкурентните системи една до друга — GPT, Gemini и Claude са в Google Cloud — и когато един модел на три точки от върха струва наполовина, разговорът за “най-добрия” започва все по-често с таблицата с тарифите.
Заключение
Kimi K3.1 Pro не детронира Claude Opus 5.5 — изостава и на Terminal-Bench, и на GDPval, и на BenchCAD. Но го прави на половин цена, а на 4 ноември теглата му трябва да станат публични. Ако датата бъде спазена, за първи път модел от този клас ще може да се пуска локално, което е по-значимото събитие от трите точки в класацията. Повече подробности има в материала на The Decoder и в официалния блог на Moonshot.
Харесва ви? Отбележете ни и ще ни виждате по-нагоре в Google.
Предпочитан източник в Google