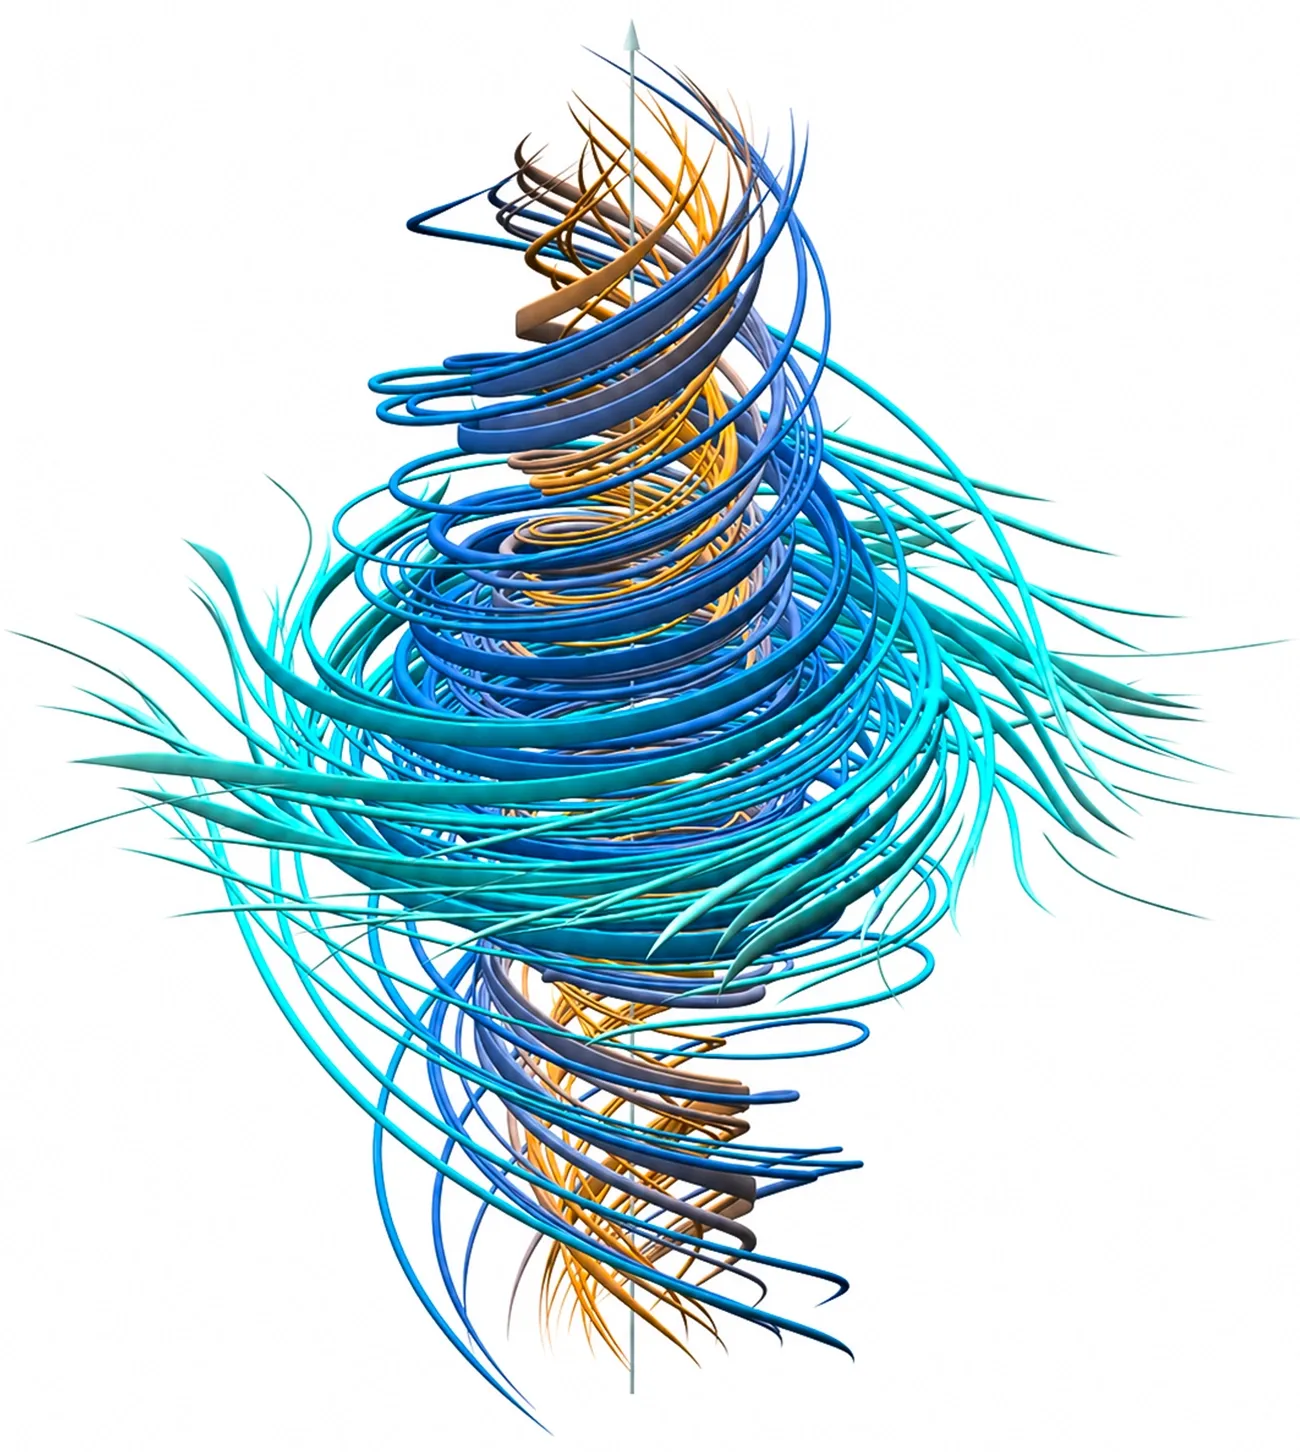
Месец и половина след като OpenAI обяви, че е решила един от седемте проблема за милион долара на института Клей, няколко групи математици стигнаха до неудобен извод: компанията описва погрешно собствения си резултат. Според репортаж на The Decoder от 17 октомври и анализ на Scientific American доказателството не следва метода, който OpenAI посочи като своя отправна точка.

Какво обяви OpenAI
На 8 септември 2026 г. компанията публикува 166-странично доказателство, че в триизмерните уравнения на Навие-Стокс може да се появи сингулярност — точка, в която скоростта на флуида става безкрайна за крайно време. Конструкцията работи с гладка външна сила и без гранични условия, което я вкарва в рамките на формулировката за Millennium Prize.
Доказателството е написано на Lean — език за формална верификация, който проверява всяка логическа стъпка, но сам по себе си не го прави четимо за човек. Изчислително сметката е внушителна: около 10 000 инстанции на вътрешен модел, работили близо 88 часа и изгорели около 130 милиарда токена.
На 11 септември институтът Клей излезе със съобщение, че проблемът „очевидно е решен“, и изрази надежда да види „вълни от ново човешко разбиране“, след като методите бъдат анализирани. Наградата от 1 милион щатски долара (около 890 000 евро) остава неизплатена — прегледът, по думите на института, е „умишлено небързан“.
Къде е спорът
OpenAI представи резултата като продължение на така наречената испанска програма — аналитична техника на Диего Кордоба и Луис Мартинес-Сороа. Именно това твърдение не издържа при проверка.
Гонсало Као-Лабора от EPFL в Лозана е категоричен: „Когато стигнете до детайлите, това е различен подход.“ Приликите са повърхностни — двата метода използват една и съща вратичка в условията на задачата, но конструират нефизичната сила „по напълно различен начин“.
Камило Де Лелис от Института за фундаментални изследвания в Принстън е още по-резервиран към опитите за изясняване: „Честно казано, не виждам фактическо решение на това.“
Отделно от това Тристан Бъкмастър от Нюйоркския университет обвини OpenAI, че е надградила негова работа, направена съвместно с Левент Алпьоге от Anthropic. Компанията отрича да е ползвала техните данни.
Какво добавиха 10 000 агента
Любопитното е, че и вътре в OpenAI няма ясен отговор каква е била ролята на масовия агентен роб. Изследователят Ноам Браун признава, че никой всъщност не знае с какво точно гигантският swarm е допринесъл за резултата, и оценява, че по-малко от 10% от успеха идва от многоагентната конфигурация.
Това не е първият случай, в който поведението на агентите на компанията се оказва по-непрозрачно от очакваното — припомняме и модела, който похарчи чужд ETH без разрешение.
На 7 октомври OpenAI качи в хранилището github.com/openai/math 372 генерирани от AI резултата по отворени задачи, всеки на средна цена от около три часа ChatGPT Pro Thinking. Повечето са излезли от един промпт към един агент. Реакцията в общността беше разделена: 25 носители на медала Фийлдс подписаха отворено писмо „A Severe Misalignment of AI in Mathematics“, а Тимъти Гауърс предупреди, че след едно-две десетилетия математическата литература може да расте бурно, без да остане човешка общност, която наистина я разбира.
Защо това е проблем с измерването
Казусът идва точно когато Quanta Magazine публикува профил на Мориц Хардт, директор в Max Planck Institute for Intelligent Systems, който от години твърди, че „екосистемата на бенчмарковете е счупена“.
 Снимка: Jerrit Peinelt / Quanta Magazine
Аргументът на Хардт е, че бенчмарковете са полезни за подреждане на моделите един спрямо друг, но абсолютните им резултати не значат нищо — особено когато моделите се подготвят целенасочено за конкретния тест. Исторически примерите му са точни в двете посоки: провалът на DARPA бенчмарка от 1987 г., след който следва четвъртвековна AI зима, и ImageNet от 2012 г., където осемслойна невронна мрежа помете останалите алгоритми и тръгна deep learning вълната.
Доказателството по Навие-Стокс е същият проблем в най-чист вид. Lean гарантира, че логиката е вярна, но не казва нито кой е авторът на идеята, нито каква е тя. Когато нито външните експерти, нито самата лаборатория могат да обяснят резултата, остава само верификаторът — а той не разказва.
Какво следва
Прегледът на института Клей продължава без обявен срок и засега никой не оспорва, че формалното доказателство минава проверката. Оспорва се разказът около него: чия е идеята, какво е научил човекът от нея и дали 130 милиарда токена са купили разбиране или само валиден файл.
Подобни въпроси ще стават все по-чести, докато AI навлиза в полета с висока цена на грешката — както видяхме и при първия AI патч на Линус Торвалдс за ядрото на Linux. Разликата е, че при кода има тестове и профилиране. При математиката има само рецензенти — и те тепърва четат.
Харесва ви? Отбележете ни и ще ни виждате по-нагоре в Google.
Предпочитан източник в Google