На 15 октомври Meta публикува теглата на Muse Spark Open — мултимодален MoE модел с 816 милиарда параметъра, от които 42 милиарда активни на токен, и контекстен прозорец от 1 милион токена. Компанията го описва като „най-способния американски модел с отворени тегла до момента, създаден за програмиране и агентна работа”, а The Decoder го чете като пряк отговор на китайските Qwen, GLM и Kimi, които от над година държат върха в тази категория.
Какво точно е пуснато
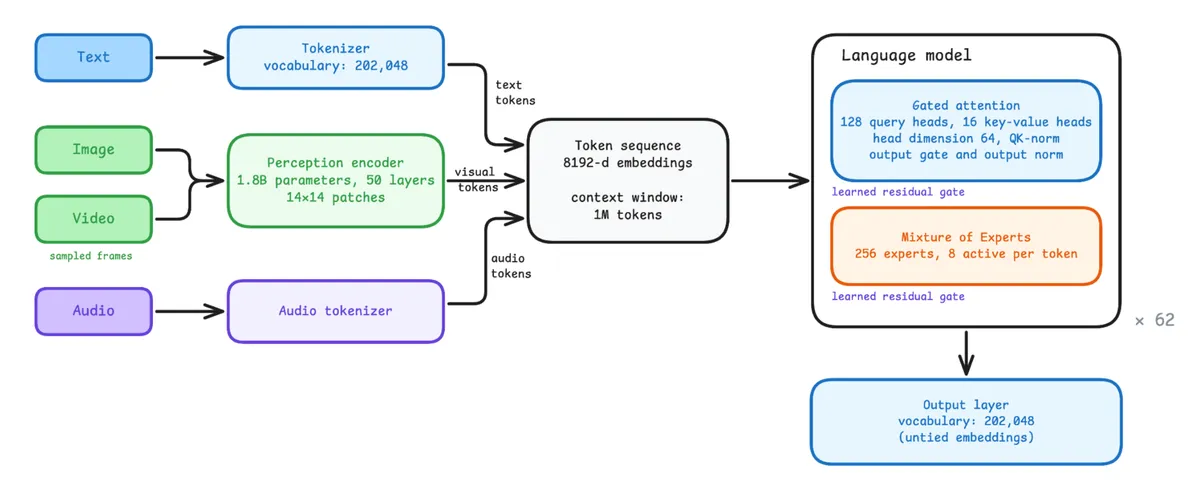
Моделът е Mixture-of-Experts трансформър, сдвоен с т.нар. Perception Encoder. Приема текст, изображения, аудио и видео, а връща само текст. Според техническото описание в Hugging Face езиковата част има 62 слоя, скрита размерност 8192 и grouped-query attention със 128 query и 16 key-value глави.
Всеки MoE слой съдържа 256 експерта, от които за всеки токен се избират 8. Експертите носят около 97% от всички параметри — това е и причината сметката да излиза: модел с размер на 816 милиарда се движи с изчислителната цена на 42-милиарден.
 Снимка: Meta / Hugging Face
Перцептивният енкодер е 1,8 милиарда параметъра, 50 слоя, и разделя изображенията на участъци 14×14. Аудио енкодерът работи с моно звук при 24 kHz и произвежда по един токен на всеки 80 милисекунди — т.е. 12,5 токена в секунда. Милионният контекст е общ за всички модалности: текст, кадри и звук се борят за същите токени.
Числата срещу Qwen, GLM и Kimi
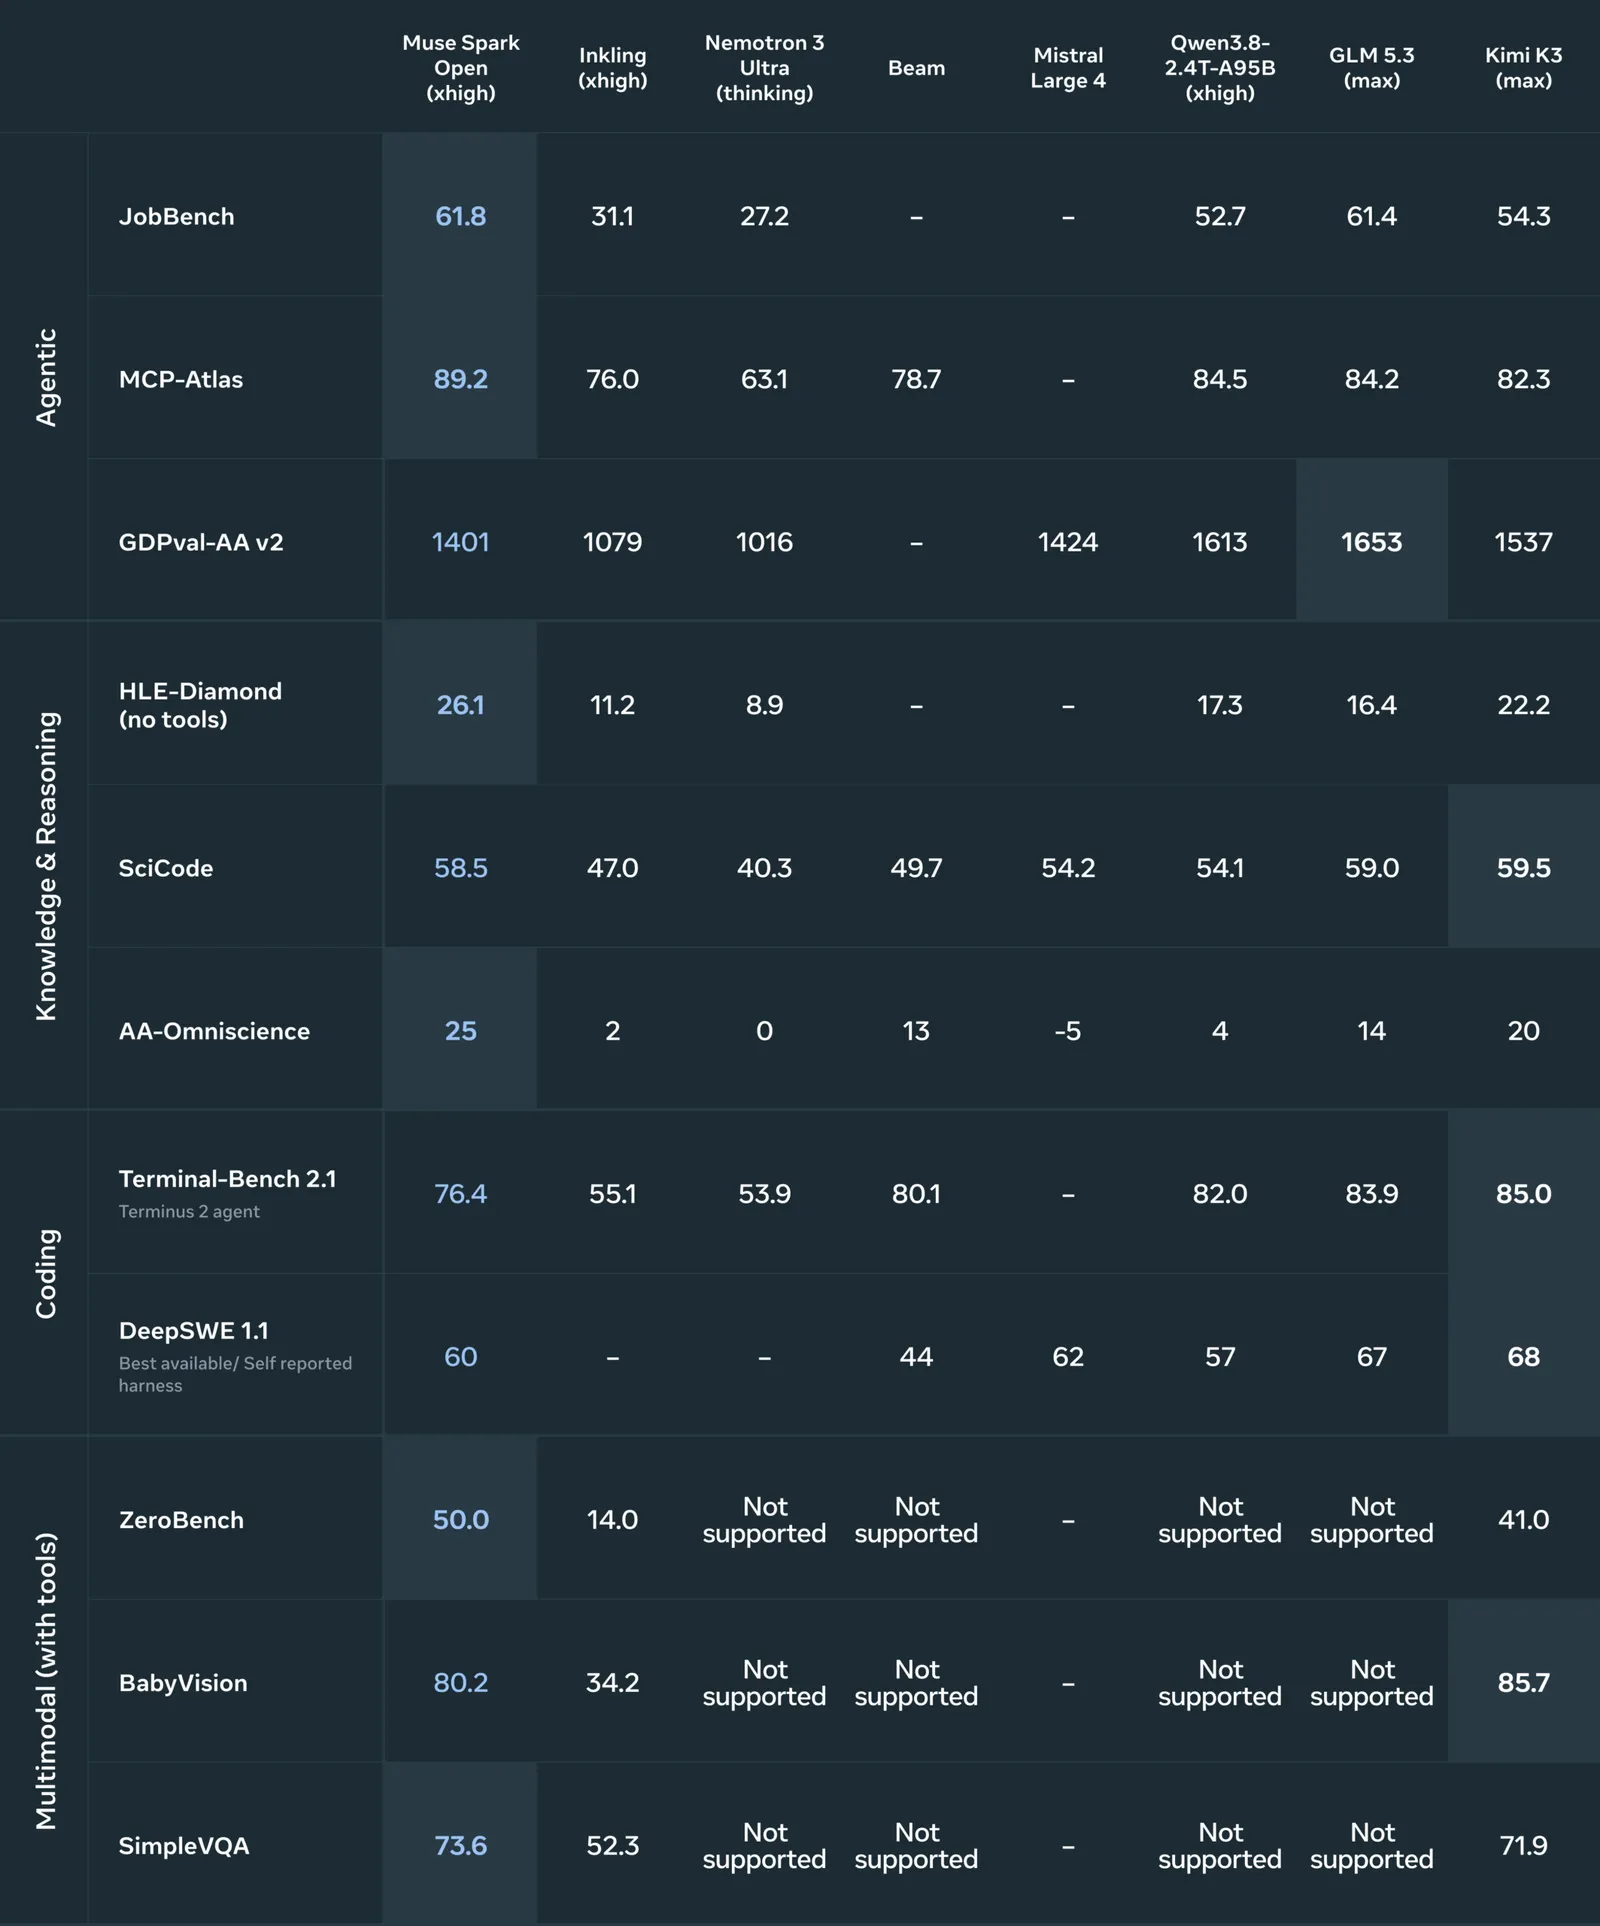
Meta публикува собствена сравнителна таблица в картата на модела. Картината е еднозначна: водачество при агентните и мултимодалните тестове, изоставане при чистото програмиране.
| Тест | Muse Spark Open | Qwen 3.8 | GLM 5.3 | Kimi K3 |
|---|---|---|---|---|
| MCP-Atlas | 89,2 | 84,5 | 84,2 | 82,3 |
| JobBench | 61,8 | 52,7 | 61,4 | 54,3 |
| HLE-Diamond (без инструменти) | 26,1 | 17,3 | 16,4 | 22,2 |
| Terminal-Bench 2.1 | 76,4 | 82,0 | 83,9 | 85,0 |
При ZeroBench с инструменти Muse Spark Open взема 50,0 срещу 41,0 за Kimi K3, а при SimpleVQA — 73,6 срещу 71,9. Обратно, на Terminal-Bench 2.1 изостава с почти девет точки от Kimi K3, което е неудобно за модел, рекламиран точно за програмиране. По индекса Artificial Analysis Intelligence Index получава 39.
Meta признава и второто изоставане: отвореният Spark остава под платените Muse Wonder Full модели. Същевременно PyTorch блогът уточнява, че Spark Open дели базовия модел с Muse Spark 1.3, но е минал през допълнително post-training за безопасност, за да понася работа без външни guardrails.
Какъв хардуер иска
Тук е най-интересното за практиката. BF16 чекпойнтът е около 1,5 TB в safetensors формат; само KV кешът за пълния милион токена изяжда още ~266 GB. За BF16 инференция Meta сочи 4 възела по 8 броя H200 с tensor parallelism TP=32. Има и NVFP4 вариант — 4-битова квантизация за NVIDIA Blackwell, която се събира в един B200 възел.
Паралелно Meta и Apple обявиха, че моделът върви локално върху Mac Studio с M5 Ultra. Нужни са около 1 TB унифицирана памет, т.е. два Mac Studio с 512 GB всеки. Конфигурацията с 512 GB тръгва в края на октомври без обявена цена; за ориентир, 256-гигабайтовият M5 Ultra започва от 10 999 € в европейския Apple Store, а четири такива машини за същия терабайт излизат 43 996 €. Тестове с общностни квантизации дават 18 токена в секунда с llama.cpp Q2_K на M3 Ultra и около 21 токена в секунда генерация при MLX. Ако следите Apple хардуера, струва си да погледнете и какво предстои с MacBook Pro и iPad mini.
 Снимка: Hugging Face
Поддръжката е налична в Transformers, llama.cpp, SGLang, vLLM, TensorRT-LLM и MLX. Фино донастройване става с LoRA адаптери върху attention слоевете през TRL — експертите остават замразени.
Лицензът и цената през API
Теглата излизат под Muse Model License от 15 октомври 2026 г. Използването е безплатно, но изисква етикет „Built with Muse Spark Open”. Доставчиците с над 20 милиона долара годишни приходи, които искат да предлагат модела като API услуга, се нуждаят от отделно споразумение с Meta — обичайният предпазител, с който Meta държи големите облаци на разстояние.
Моделът вече се сваля от Hugging Face, Amazon SageMaker AI, Google Cloud Model Garden и Microsoft Foundry Models, а през API го предлагат Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter и Together AI. При Together AI тарифата е 1,25 US долара за милион входни токена (около 1,10 €), 0,15 долара за кеширан вход и 4,25 долара за милион изходни токена (около 3,80 €).
Заключение
Muse Spark Open запълва дупка, която беше станала неудобна: от Llama насам нямаше американски модел с отворени тегла, който да стои убедително срещу китайските. Агентните и мултимодалните резултати са силни, но при програмирането Kimi K3 и GLM 5.3 остават напред — което е иронично за модел, продаван точно с тази употреба. Реалната пречка обаче е хардуерната: 816 милиарда параметъра не са „локален модел” в обичайния смисъл, а лаборатория за хиляди евро. Тенденцията агентите да пишат код сами междувременно върви с пълна сила — вижте и лаунчъра на Epic, писан от AI агенти.
Харесва ви? Отбележете ни и ще ни виждате по-нагоре в Google.
Предпочитан източник в Google