Nvidia Vera: ARM чип срещу 20 години дизайн
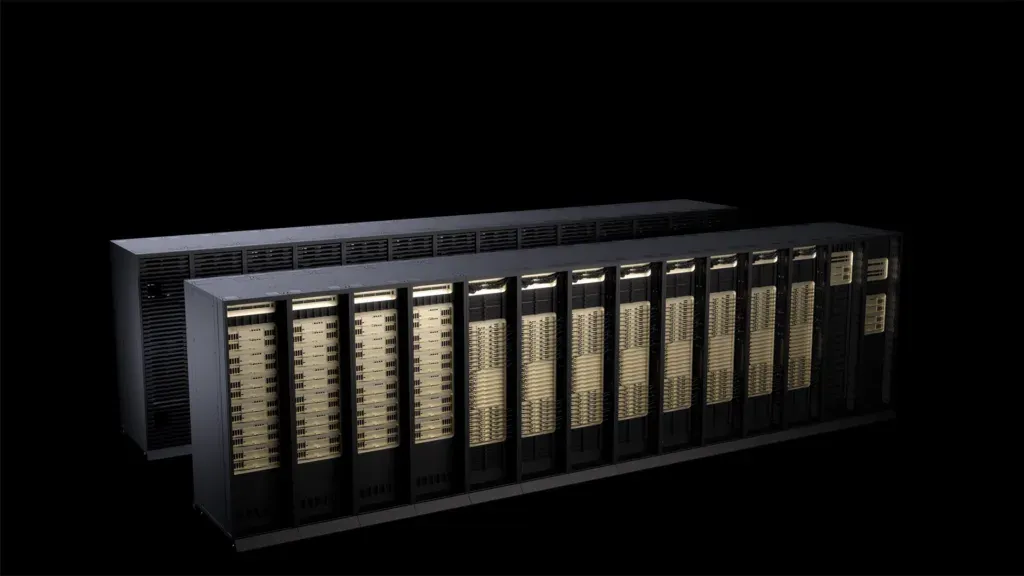
Nvidia публикува подробен технически разбор на Vera — първия си напълно собствен сървърен процесор — и с него отправя пряко предизвикателство към близо двадесетгодишната логика на дизайна на дата център CPU. Вместо да гони рекорден брой ядра като Intel и AMD, Vera залага на 88 мощни ядра „Olympus“, 176 нишки и радикално по-бърза памет, оптимизирани за една конкретна задача: да не карат скъпите GPU да чакат. Данните са от бяла книга и вътрешни SPEC CPU 2026 тестове на компанията от юли 2026 г., които все още не са независимо потвърдени.
Собствено ядро, а не лицензирано ARM
Ключовата разлика спрямо предишния сървърен чип Grace е, че Olympus не е взето наготово. Grace ползваше стандартни Neoverse ядра на ARM; Vera е първото ядро, което Nvidia проектира сама, само по инструкционния набор Armv9.2. Това дава на инженерите свобода да оразмерят конвейера точно за своите натоварвания.
Резултатът е широк, агресивен фронтенд: 10-широк декодер, извличане до 16 инструкции на цикъл, дълбоко пренареждане и prefetch по шаблони. Цялото ядро е върху монолитен compute die — за разлика от чиплетния подход на конкуренцията — свързан чрез второ поколение Scalable Coherency Fabric с 3,4 TB/s bisection пропускателна способност. Nvidia твърди двойна производителност на ядро спрямо Grace и до 3x по-висока честотна лента между ядрата в сравнение с чиплетни дизайни.
Spatial multithreading вместо класически SMT
Vera изпълнява 176 нишки на 88 ядра, но не по познатия начин. Вместо класически SMT, при който две нишки се борят за едни и същи ресурси, Nvidia използва spatial multithreading — всяка нишка получава дялово разпределени изпълнителни ресурси. Едната нишка може да върви с висока пропускателна способност, докато другата обработва прости задачи, или двете да работят като независими среди. Това е компромис, зареден точно за латентно-чувствителните управляващи задачи на агентния AI.
Паметта е другата голяма разлика. Vera ползва LPDDR5X, закалена за дата център с ECC телеметрия — до 1,5 TB капацитет и 1,2 TB/s пропускателна способност. Nvidia посочва около 3x повече лента на ядро спрямо DDR дизайни, до 5x по-добра ефективност на ват и 40% по-ниска латентност под натоварване. Връзката към GPU е кохерентен NVLink-C2C с до 1,8 TB/s.
Защо Nvidia обръща логиката
Тук е философският обрат. През последните двадесет години дата център процесорите растяха предимно по едно измерение — брой ядра, от 14 до над 128. Vera умишлено върви срещу това течение и оптимизира максимална еднонишкова производителност при мащаб.
Причината е в новия тип натоварване. При агентния AI CPU-то изпълнява последователни стъпки между циклите на GPU разсъжденията — извиква инструменти, върти SQL заявки, обръща се към API-та. Всяка милисекунда CPU латентност оставя скъпоструващия GPU да стои празен. Или както го формулира Nvidia: ако по-бърз CPU връща GPU-то на работа по-рано, цената на процесора се превръща в закръгляща грешка в общата стойност на стелажа, а битката се измества от „долари за ядро“ към „токени за стелаж“.
Реалните примери, които компанията цитира: Perplexity с 1,5x по-бързи sandbox среди за код, NYSE с 6x по-ниска p99 латентност и Los Alamos със 7x на агентни натоварвания.
Как се вписва във Vera Rubin
Vera не се продава като самостоятелен продукт, а е половината от свързката Vera Rubin. Процесорът се сдвоява с новите Rubin GPU в две изпълнения: плътен, водно охлаждан стелаж с 256 CPU и над 22 000 ядра, и въздушно охлаждан 2U сървър с двусокетна конфигурация. Пълната система Vera Rubin NVL72 обединява 36 Vera CPU и 72 Rubin GPU, а CoreWeave измери 10x повече токени в секунда на мегават спрямо предходната Grace Blackwell платформа.
Предизвикателство към Intel и AMD
С Vera Nvidia влиза директно на терена на AMD Epyc „Venice“ (до 256 ядра) и Intel „Diamond Rapids“. По вътрешни SPEC CPU 2026 данни Vera изпреварва с малко AMD Epyc 9755 (Turin) при чувствително по-малко нишки и стои над Intel Xeon 6980P, а Phoronix я описа като „най-добрата производителност, виждана някога на ARM“.
По-важен от бенчмарковете обаче е ходът на разговора. Докато Intel се опитва да „прескочи“ ARM и AMD с връщане към растеж, а AMD чертае пътна карта до Zen 8 през 2030 г., Nvidia се опитва да пренапише самите правила — от икономика на ядрото към пропускателна способност на целия стелаж. Ако този модел се наложи, класическият дата център CPU може да се окаже мерен с грешна мерна единица.
Харесва ви? Отбележете ни и ще ни виждате по-нагоре в Google.
Предпочитан източник в Google