На 5 октомври OpenAI обяви, че започва да вгражда невидим воден знак в текста, който ChatGPT и Codex генерират за потребителите в Европейския съюз. Технологията се нарича textGrain, включва се за всички абонаментни планове в ЕС и ще се разгърне „през следващите седмици“. Поводът е член 50 от AI Act — разпоредбите за прозрачност, които влязоха в сила на 2 август 2026 г. и изискват съдържанието, създадено от изкуствен интелект, да може да бъде разпознато като такова.
Извън ЕС нищо не се променя по подразбиране. Разработчиците, които ползват API, могат да включат водния знак доброволно за избрани модели още от 5 октомври, но настройката е изключена по подразбиране. През Microsoft Azure опцията също ще се появи в следващите седмици.
Как работи textGrain
Водният знак не добавя скрити символи, нулеви интервали или метаданни в текста — именно затова преживява копиране и поставяне. Вместо това той се намесва в самия избор на думи: на всяко място, където няколко думи биха паснали еднакво добре, секретен ключ подрежда предсказанията на модела и решава коя да бъде използвана. Стотици такива дребни побутвания в едно по-дълго изложение образуват статистически модел, който е невидим за човешкото око, но е разпознаваем от детектор.
По данни на OpenAI включването на водния знак не влошава чувствително качеството — резултатите на GPT‑6 Astra в бенчмарковете остават сходни с тези без него.
 Снимка: OpenAI / the-decoder.com
Числата, които охлаждат ентусиазма
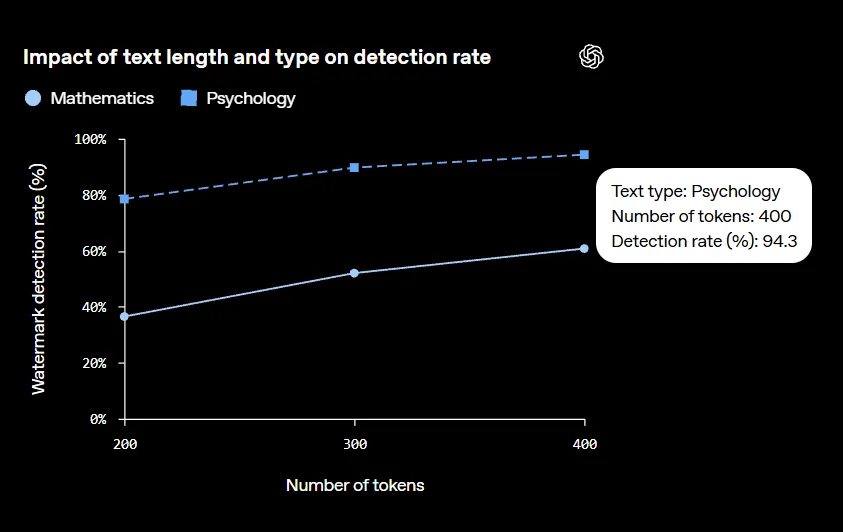
Самата компания публикува доста откровени данни за границите на метода. При идеални условия — непроменен текст — детекцията е около 92%. Разбито по дължина: при пасаж от 200 токена успеваемостта е около 80%, при 400 токена се качва до около 95%. Колкото по-кратък е текстът, толкова по-слаб е сигналът.
Редактирането сваля резултата бързо:
- замяна на 10% от думите със синоними → детекция 66%
- замяна на 25% от думите → детекция 17%
Има и тематична разлика. При математика изборът на думи е твърде ограничен, за да има къде да се скрие сигнал, и успеваемостта пада до около 60% дори при 400 токена. Превод на друг език също чупи водния знак.
Оттук идва и най-важната уговорка: „Липсата на открит воден знак не доказва човешко авторство“, пише OpenAI. И още — водният знак „може да покаже, че система на OpenAI е генерирала или обработила част от пасажа, но не и колко човешка преценка, редакция или творчество са вложени в него“.
Детекторът не е за всеки
Точно заради тази чупливост OpenAI няма да пусне публичен детектор. Достъп ще се дава само на одобрени изследователи и експертни организации, по заявление и за всеки случай поотделно, в рамките на кодекса за добри практики на ЕС относно съдържанието, генерирано от AI.
Компанията изрично изброява какво детекторът не прави: не идентифицира потребителя, не разкрива подадения промпт, не установява собственост или отговорност и не проверява дали текстът е верен. Ако очаквате преподавателите и работодателите да получат надежден бутон „това е от ChatGPT“ — няма да стане, поне не засега.
 Снимка: OpenAI / the-decoder.com
Контекстът: Anthropic мина по същия път
Ходът не е първи. Около два месеца по-рано Anthropic включи воден знак в текста на Claude — но глобално и без възможност за изключване, което предизвика сериозно недоволство сред потребителите, които се опасяваха от проверки на работното място и в университета. OpenAI очевидно е избрала по-меката схема: задължително там, където регулацията го изисква, доброволно навсякъде другаде.
Темата за това докъде стигат данните от един AI чат и кой има достъп до тях не е хипотетична — достатъчно е да си припомните случая с дневника в Claude, който Anthropic препрати на полицията. Разликата тук е, че водният знак по дефиниция не носи информация за това кой е писал, а само че машина е участвала.
Какво означава това за вас
Ако сте в ЕС и ползвате ChatGPT или Codex, няма да забележите нищо — текстът изглежда и се чете по същия начин. Ако пишете код в Codex, водният знак е по-слаб: синтаксисът оставя малко свобода в „избора на дума“, подобно на математиката.
Практическият извод е по-скоро обратен на очакваното. Системата е достатъчно добра, за да маркира съдържание в голям обем — например при проверка дали дадена платформа е залята с машинен текст. Тя не е достатъчно добра, за да обвините конкретен човек в конкретно есе, особено ако той е минал през текста и е сменил няколко думи.
Заключение
textGrain е първото голямо внедряване на воден знак в текст от OpenAI и е по-скоро регулаторно задължение, отколкото продуктова функция. Компанията — която и без това минава през вътрешни критики за темпото и културата си — е свършила минимума, който AI Act изисква, и честно е показала къде методът се чупи. Следващите седмици ще покажат колко бързо ще се появят първите инструменти за „пране“ на водни знаци; 25% синоними и 17% детекция са твърде достъпна рецепта, за да остане неизползвана.
Източници: BleepingComputer, TechCrunch, the Decoder и официалното съобщение на OpenAI.
Харесва ви? Отбележете ни и ще ни виждате по-нагоре в Google.
Предпочитан източник в Google