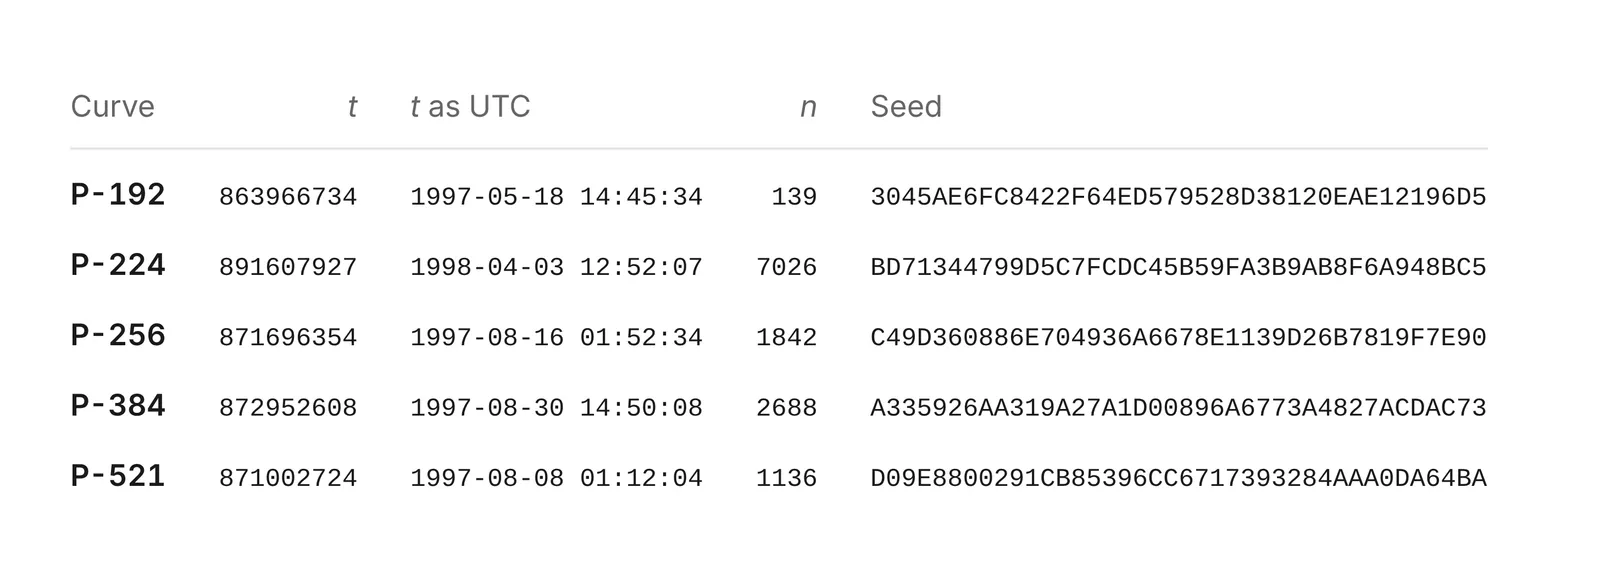
Anthropic публикува на 16 октомври 2026 г. резултат, който криптографската общност чакаше четвърт век: откъде идват загадъчните начални стойности (seeds), с които NSA е генерирала елиптичните криви на NIST. Отговорът, намерен от вътрешен изследователски модел Claude за под половин час, е разочароващо прозаичен — обикновен генератор на псевдослучайни числа от стар C код, засят с Unix времеви маркери от 1997 и 1998 г.
Какъв беше въпросът
Когато NIST стандартизира кривите за ECDSA през 2000 г., публикува за всяка от тях по един 160-битов seed, подаден от NSA. От него се извежда параметърът на кривата чрез SHA-1. Самите seed-ове обаче бяха просто числа без обяснение — а всички знаеха, че ако подателят ги е получил от смислена фраза или от търсене по някакъв скрит критерий, това не личи от нищо.
Оттам тръгна и подозрението: дали NSA не е избрала точно тези криви, защото знае как да ги атакува. Агенцията има история в тази посока — случаят Dual_EC_DRBG е достатъчно напомняне. През 2023 г. Филипо Валсорда обяви награда за разгадаване на seed-овете, финансирана от десетина криптографи, с условието откривателят да покаже изходните фрази. Сумата достигна 12 288 долара, а при дарение за организация с нестопанска цел се утроява до 36 864 долара.
Покойният Джери Солинас от NSA, човекът, който най-вероятно е пуснал генерирането, е отнесъл отговора със себе си — според разказите по-късно самият той не е могъл да си спомни фразите.
Как Claude стигна до отговора
Моделът е подходил не към криптографията, а към статистиката. Сканирал е публикуваните seed-ове бит по бит и ги е сравнявал с изходите на 34 комбинации от генератори и формати на изход, характерни за C библиотеки от 90-те.
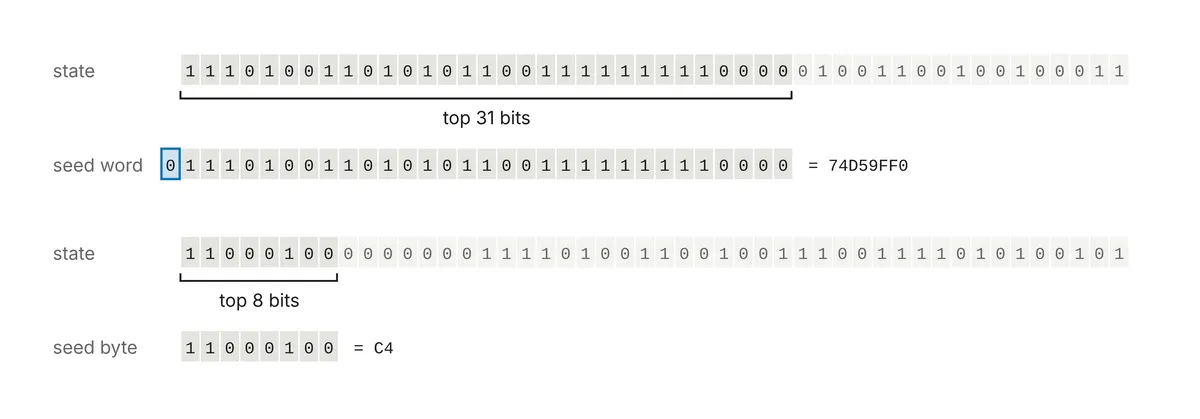
Уловката е открита при четири от десетте seed-а: най-горният бит на всяка дума е нула — съвпадение, което случайно би се получило с вероятност около 1 към 5810. Това е подписът на lrand48, линеен конгруентен генератор с 48-битово вътрешно състояние, който връща само 31 от тези битове. Оттам нататък Claude е използвал решетъчна редукция (алгоритъмът LLL), за да възстанови орязаните състояния и да изчисли началното засяване.
 Снимка: Anthropic
Резултатът е списък с дати и часове с точност до секундата:
P-192  18 май 1997, 14:45:34   — кандидат 139
P-256  16 авг. 1997, 01:52:34  — кандидат 1842
P-384  30 авг. 1997, 14:50:08  — кандидат 2688
P-521   8 авг. 1997, 01:12:04  — кандидат 1136
P-224   3 апр. 1998, 12:52:07  — кандидат 7026
Никакви английски фрази, никакви имена на агенти — просто time(), подаден на srand48, и въртене на цикъл, докато излезе годна крива.
Като бонус моделът е обяснил и произхода на базовите точки на шест криви (P-192 и петте примерни криви от ANSI X9.62). Те идват от генератора в FreeLIP — пакета за дълга аритметика на Арйен Ленстра — със seed-ове 20000, 20420, 20507, 20509, 20512 и 20517. Това не е било обяснявано досега от никого.
Какво не е доказано
Anthropic е категорична: „Това не е криптографски пробив, нова атака или слабост в кривите на ECDSA.“ Находката не разчиства подозренията напълно, а по-скоро ги стеснява.
Останаха отворени въпроси. При P-256 публикуваният seed е кандидат 1842, но кандидат 876 от същия цикъл също дава годна крива с правилния размер — защо е прескочен, не се знае. При P-224 са пропуснати три такива, при примерните криви на ANSI — още седем. Авторите смятат, че толкова малък брой пропуски не стига за подбор на отслабени криви: това би означавало, че слабите криви са чести и лесни за намиране.
Петият двоичен seed, този на B-163, не пасва на нищо и остава необяснен. Базовите точки на P-224, P-256, P-384 и P-521 — също.
Наградата от 36 864 долара е дарена на Internet Security Research Group, организацията зад Let’s Encrypt.
Защо това има значение
Освен за историята на криптографията, случаят е и показателен за това какво върши AI днес: не доказва нова теорема, а изчерпва пространство от хипотези, което човек не би обходил ръчно. Същият модел на употреба видяхме и когато Торвалдс прати първия си патч, написан с Claude Code.
Струва си обаче да се отбележи и другата страна. Резултатът е проверим независимо — всеки може да пусне lrand48 с посочените времеви маркери и да сравни. Точно това го отличава от случаи като спора около „доказателството“ на OpenAI по Навие-Стокс, където твърдението беше трудно за проверка. Когато AI даде отговор, който се проверява за минути, дебатът е за фактите, а не за това дали моделът разбира какво е казал.
Харесва ви? Отбележете ни и ще ни виждате по-нагоре в Google.
Предпочитан източник в Google